


题目
循环队列怎么实现
答案
@[toc]
---
## 队列定义
同样也是操作受限的线性表,底层也是基于数组实现,但顺序是**先进先出FIFO**,从队尾进队,从队头出队
队列分为:
- 顺序队列
- 循环队列
- 链式队列
- 双端队列
## 顺序队列
### 顺序队列定义
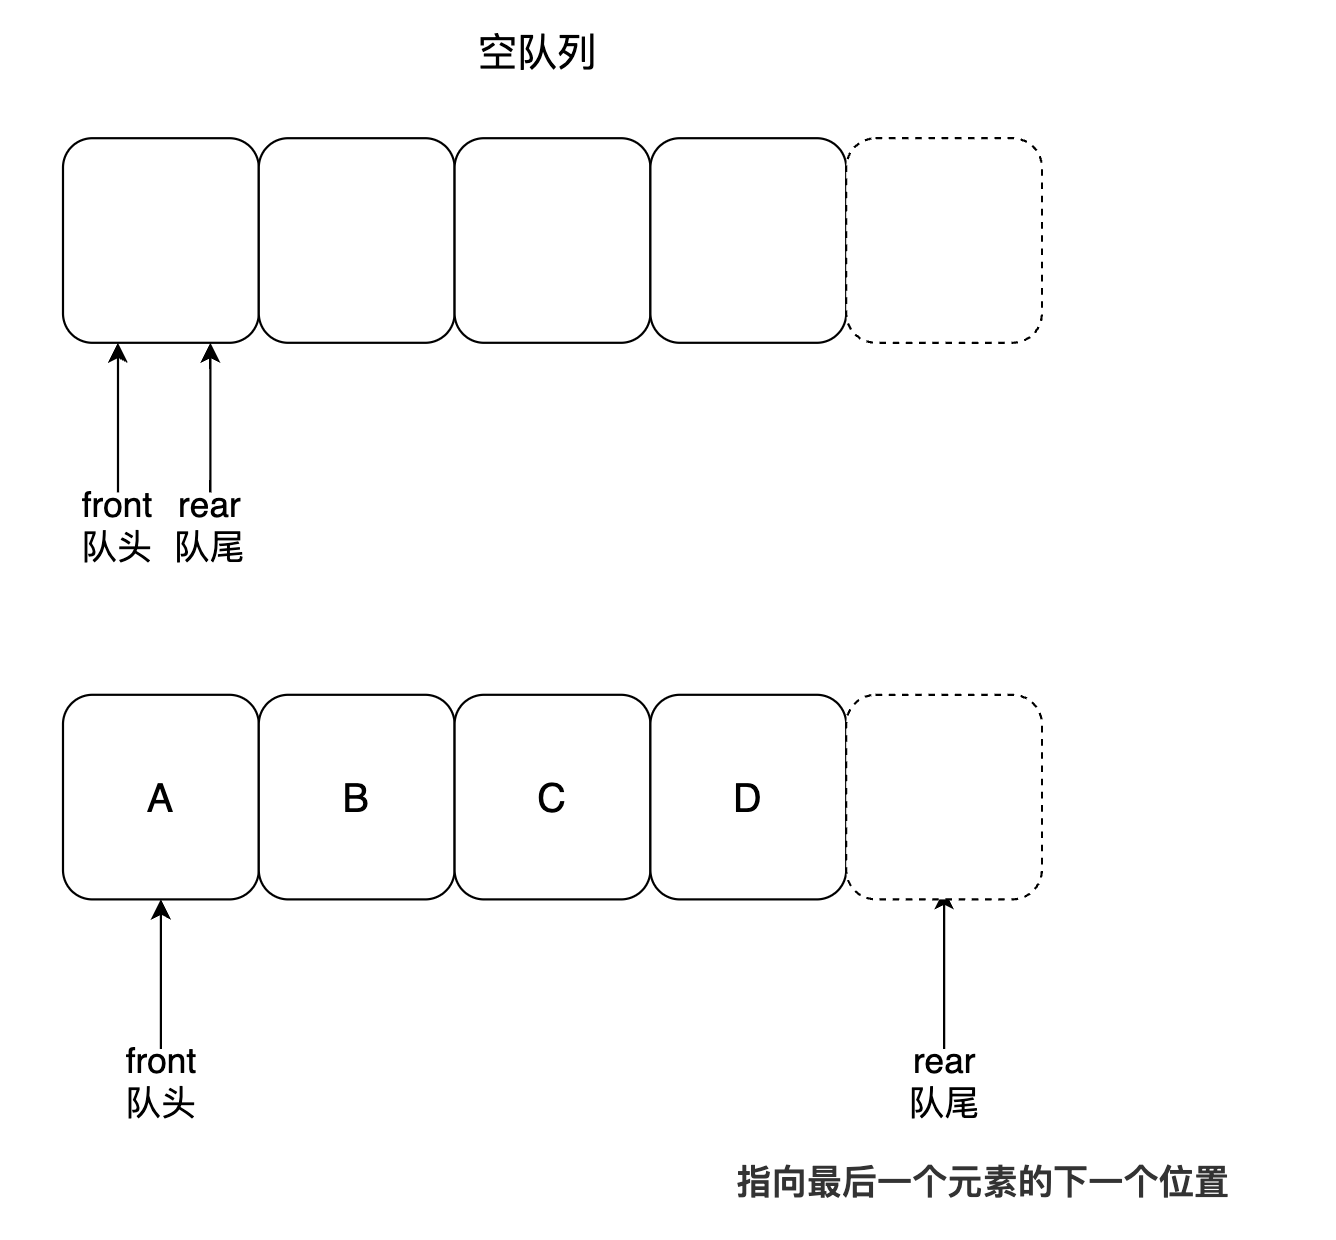
队列的底层是数组,我们常说的队列其实就是顺序队列,其数据结构定义一般是:
1. 队头指针指向数组第一个元素
2. **队尾指针指向数组最后一个元素的下一个位置**
为了避免当只有一个元素时,队头和队尾重合使处理变得麻烦,所以这里引入了队头和队尾两个指针,假设 `front` 指针指向队头元素,`rear` 指针指向队尾元素的下一个位置,这样:
- 当 `front == rear` 时,表示这个队列是空队列
- 当 `front == rear + 1` 时,表示这个队列中只有一个元素
示意图如下:
众所周知,队列是先进先出的,那么进队操作对应的步骤就是:先送值到队尾,再将队尾指针 +1
```cpp
// 送值到队尾
queue[rear] = x;
// 队尾指针 +1
rear ++;
```
出队操作:先取出队头元素,再将队头指针 +1
```cpp
// 取出队头元素
x = queue[Q.front]
// 队头指针 +1
front ++;
```
### 假溢出问题
顺序队列存在**假溢出问题** ,就是明明在队列中仍然有可以存放元素的空间却无法执行入队操作了,举个例子:
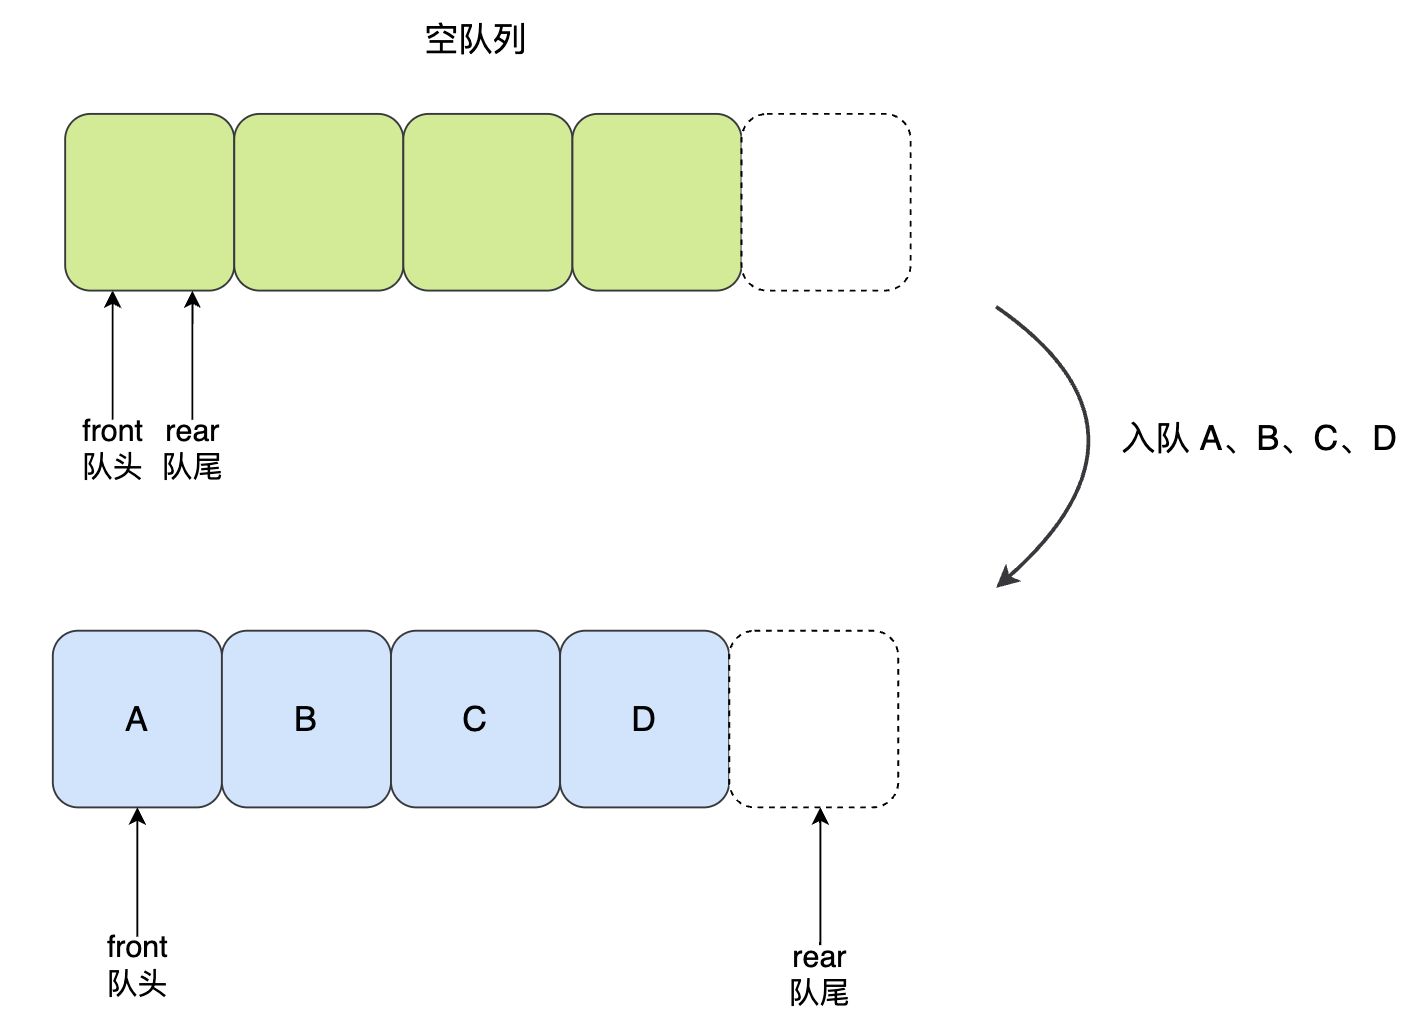
队列的大小是 5(数组容量为 5),一开始是空队列,然后依次入队了 A、B、C、D:
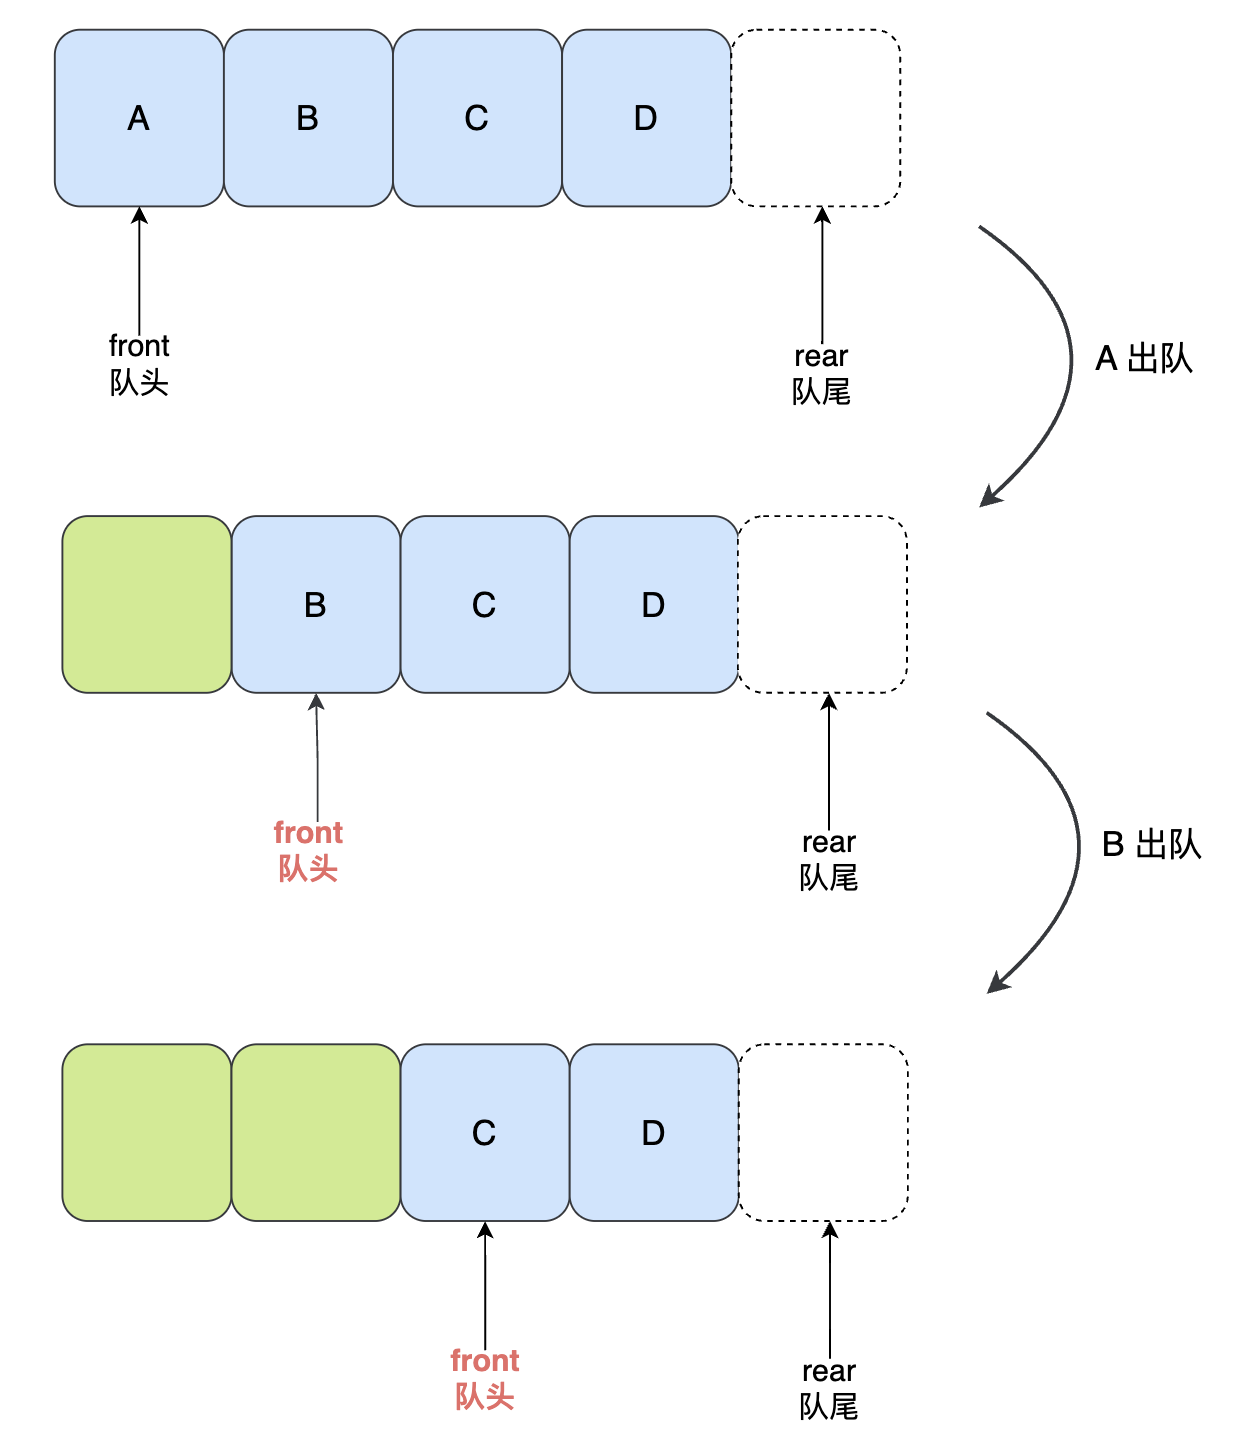
然后 A 出队,B 出队,相应的 front 指针会往后移动两位:
再入队一个新元素 E,此时 front 指针不变,**rear 指针需要 +1,已经超出了数组的下标范围**,就会导致新元素插入失败:
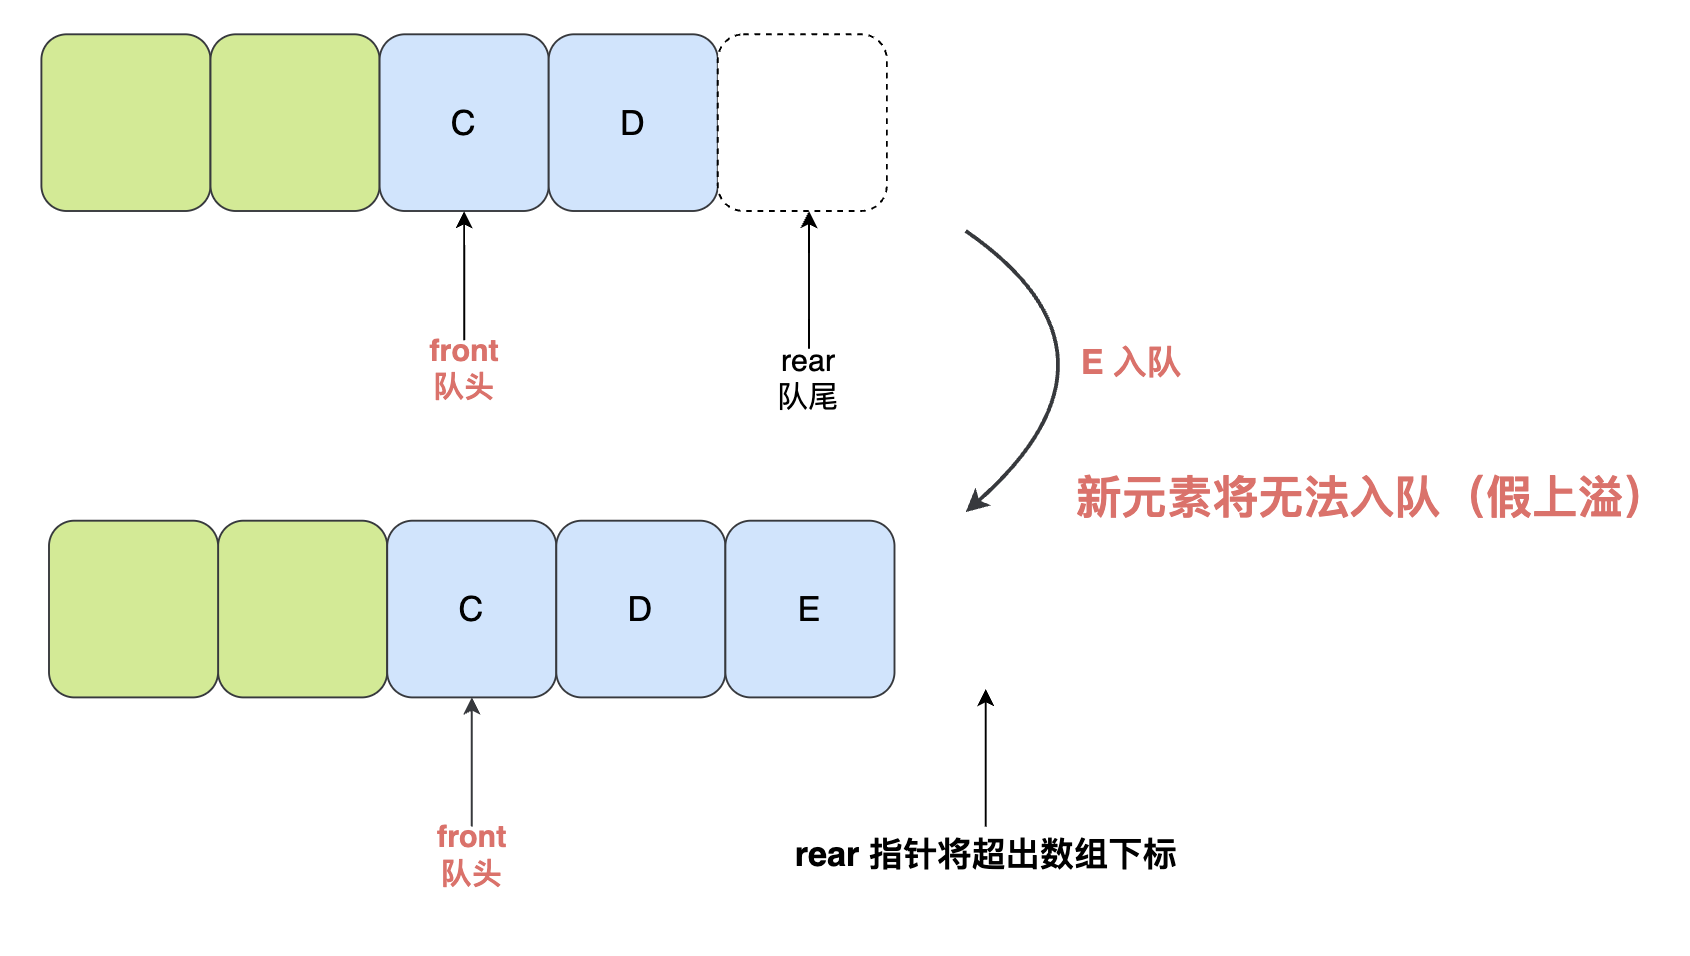
明明队列中还有空间,插入元素竟然会失败?这就是一种**假性上溢出**现象。
如何解决这个问题呢,有三种:
1. 建立一个足够大的存储空间以避免溢出。这样做空间使用率低,浪费存储空间
2. 移动元素:每当出队一个元素,就将移动队列中所有的已有元素向队头移动一个位置。这样做很明显时间复杂度比较高,效率慢
3. 循环队列:将队头和队尾看作是一个首尾相接的循环队列
因此,**循环队列是解决顺序队列假溢出问题的最佳选择**!
## 循环队列
循环队列的数据结构定义一般是:
1. 队列长度固定,即队列(数组)容量有限
2. **队列的头尾相接形成一个环,当队尾到达数组的最后一个位置时,下一个位置是数组的第一个位置**
具体实现步骤如下:
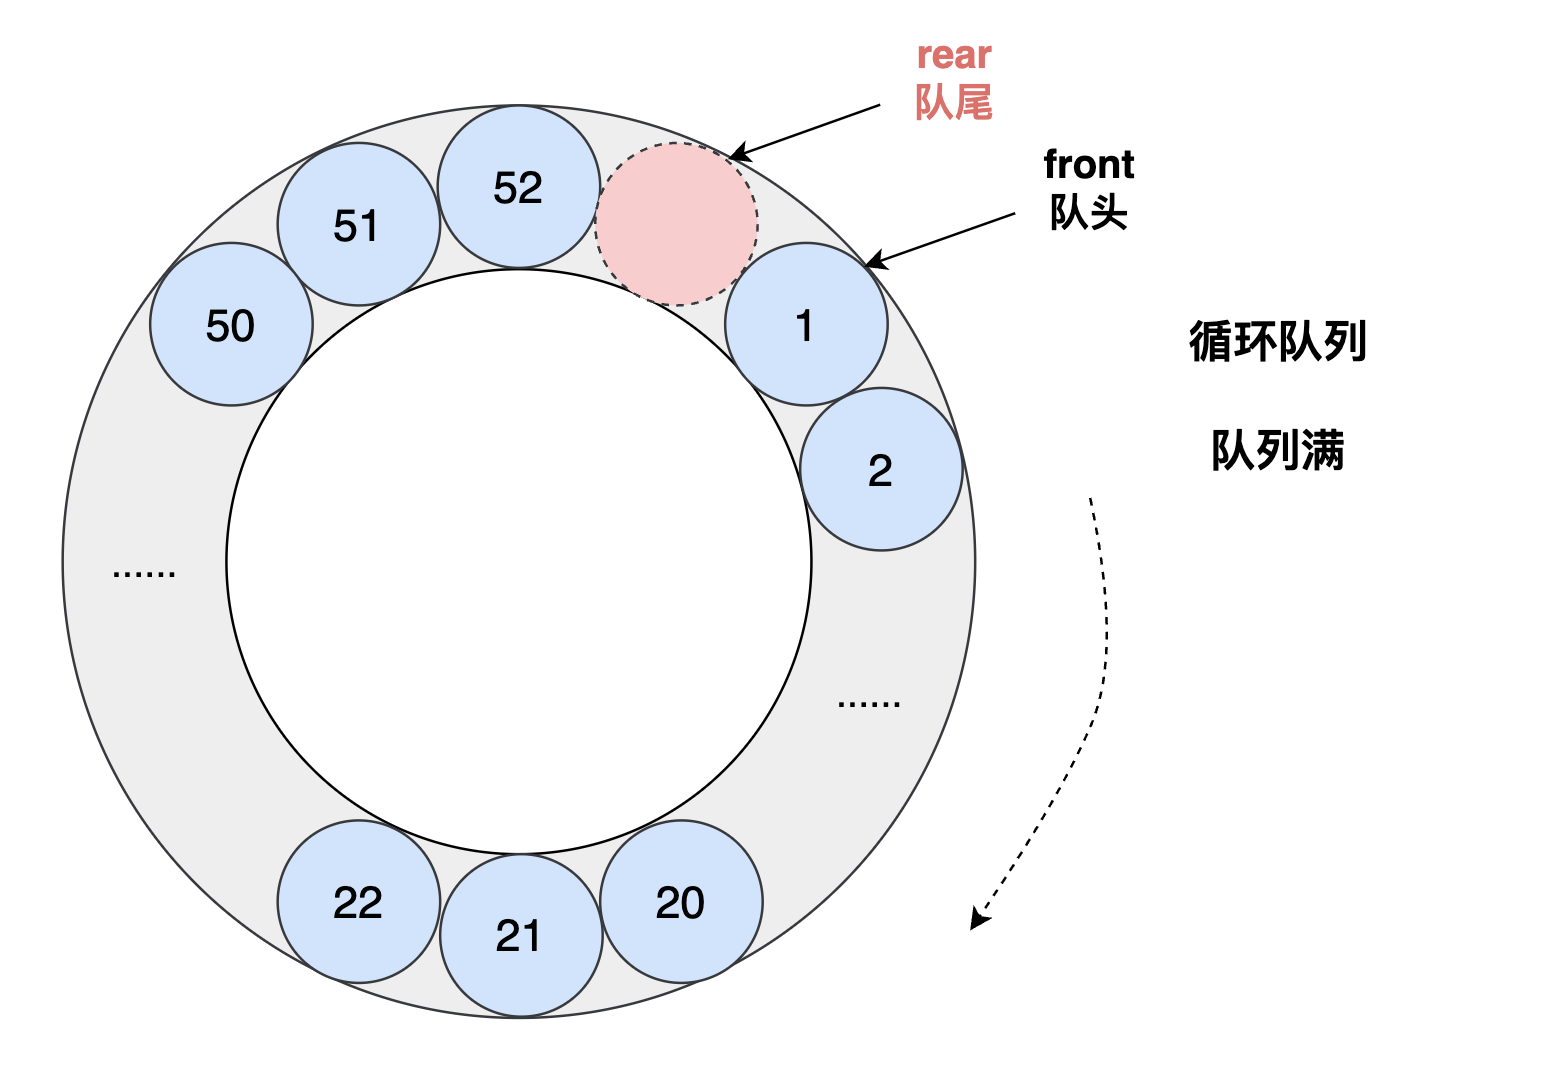
1. 定义一个数组和两个指针:`front` 和 `rear`,分别表示队头和队尾的位置。初始时(空队列),队头和队尾都指向数组的第一个位置,即 `front = rear = 0`。
2. 入队时,首先检查队列是否已满,**如何判断队列满?牺牲一个单元来区分队空和队满**:即 `(rear + 1) % maxsize = front`。如果满了则返回错误,否则将元素添加到队尾,即 `queue[rear] = element`,然后将 rear 指针向后移动一位,即 `rear = (rear + 1) % capacity`。
3. 出队时,首先检查队列是否为空,**`front == rear` 就表示队列空**。如果为空则返回错误,否则将队头元素取出并返回,即 `element = queue[front]`,然后将 `front` 指针向后移动一位,即 `front = (front + 1) % capacity`。
4. 在队列的任何时刻,队列中的元素数量为 `(rear - front + capacity) % capacity`
示意图如下:
以下是一个基于数组实现循环队列的 Java 代码示例:
```java
public class CircularQueue {
// 存储元素的数组
private int[] data;
private int front, rear;
// 数组大小
private int capacity;
public CircularQueue(int k) {
capacity = k;
data = new int[capacity];
front = 0;
rear = 0;
}
// 入队
public boolean enqueue(int element) {
if (isFull()) {
return false;
} else {
data[rear] = element;
rear = (rear + 1) % capacity;
return true;
}
}
// 出队
public boolean dequeue() {
if (isEmpty()) {
return false;
} else {
front = (front + 1) % capacity;
return true;
}
}
// 获取队头元素
public int front() {
if (isEmpty()) {
return -1;
} else {
return data[front];
}
}
// 获取队尾元素
public int rear() {
if (isEmpty()) {
return -1;
} else {
return data[(rear - 1 + capacity) % capacity];
}
}
// 判断队列是否为空
public boolean isEmpty() {
return front == rear;
}
// 判断队列是否满
public boolean isFull() {
return (rear + 1) % capacity == front;
}
}
```
简单总结就是:
- 初始/队空:`front = rear`
- 出队:`front = (front + 1) % capacity (最大元素个数)`
- 进队:`rear = (rear + 1) % capacity`
- 队列长度:`(rear - front + capacity) % capacity`
- 队满(**牺牲一个单元来区分队空和队满** ):`(rear + 1) % capacity = front`
## 链式队列
**实际就是一个同时带有头指针和尾指针的单链表**
头指针指向队头结点,尾指针指向队尾结点(即单链表最后一个结点,与顺序存储有所不同)
适合于数据元素变动较大的情况,而且不存在队列满或者溢出的问题。
- 队空: Q.rear == Q.front == NULL
- 出队:(带头结点)
```
LinkNode *p = Q.front->next;
x = p->data;
Q.front->next = p->next; //插入头节点之后
if(Q.rear = p) //若原队列中只有一个结点,删除后变空,还需修改尾指针
Q.rear = Q.front;
free(p);
```
- 进队:(带头节点)
```c
LinkNode *s = (LinkNode *) malloc (sizeof(LinkNode)); //创建新结点
s->data = x; s->next = NULL;
Q.rear->next = s; //插入到表尾
Q.rear = s;
```
## 双端队列
允许两端都进行入队和出队操作的队列
- 输出受限:有一端允许插入和删除;另一端只允许插入
- 输入受限:有一端允许插入和删除;另一端只允许删除
## 队列的应用
- 层次遍历
- 计算机系统中的应用
- 解决主机与外部设备之间速度不匹配的问题(ex:打印机数据缓冲区中所存储的数据就是一个队列)
- 解决由多用户引起的资源竞争问题(CPU将请求按时间先后排成队列)