


题目
什么是哈夫曼树?构造过程?应用场景
答案
@[toc]
---
## 树的带权路径长度
设二叉树具有  个带权叶结点,从根结点到各叶结点的路径长度与相应叶节点权值的乘积之和称为 **树的带权路径长度(Weighted Path Length of Tree,WPL)**。
设 $w_i$ 为二叉树第 i 个叶结点的权值,$l_i$ 为从根结点到第 i 叶结点的路径长度,则 WPL 计算公式如下:
$$
WPL=\sum_{i=1}^nw_il_i
$$
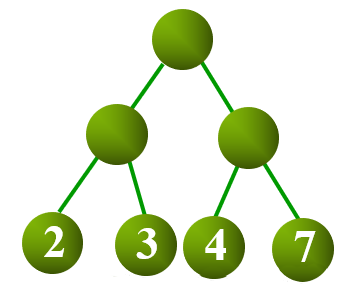
如上图所示,其 WPL 计算过程与结果如下:
$$
WPL=2 * 2+3 * 2+4 * 2+7 * 2=4+6+8+14=32
$$
## 结构
对于给定一组具有确定权值的叶结点,可以构造出不同的二叉树,其中,**WPL 最小的二叉树** 称为 **霍夫曼树(Huffman Tree)**。
对于霍夫曼树来说,其叶结点权值越小,离根越远,叶结点权值越大,离根越近,此外其仅有叶结点的度为 ,其他结点度均为 。
## 哈夫曼算法
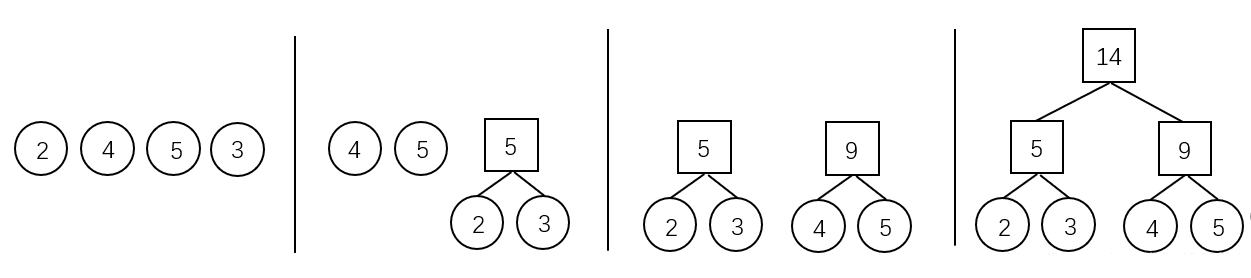
哈夫曼算法用于构造一棵霍夫曼树,算法步骤如下:
1. **初始化**:由给定的  个权值构造  棵只有一个根节点的二叉树,得到一个二叉树集合 。
2. **选取与合并**:从二叉树集合  中选取根节点权值 **最小的两棵** 二叉树分别作为左右子树构造一棵新的二叉树,这棵新二叉树的根节点的权值为其左、右子树根结点的权值和。
3. **删除与加入**:从  中删除作为左、右子树的两棵二叉树,并将新建立的二叉树加入到  中。
4. 重复 2、3 步,当集合中只剩下一棵二叉树时,这棵二叉树就是霍夫曼树。
## 哈夫曼编码
在进行程序设计时,通常给每一个字符标记一个单独的代码来表示一组字符,即 **编码**。
在进行二进制编码时,假设所有的代码都等长,那么表示  个不同的字符需要  位,称为 **等长编码**。
如果每个字符的 **使用频率相等**,那么等长编码无疑是空间效率最高的编码方法,而如果字符出现的频率不同,则可以让频率高的字符采用尽可能短的编码,频率低的字符采用尽可能长的编码,来构造出一种 **不等长编码**,从而获得更好的空间效率。
在设计不等长编码时,要考虑解码的唯一性,如果一组编码中任一编码都不是其他任何一个编码的前缀,那么称这组编码为 **前缀编码**,其保证了编码被解码时的唯一性。
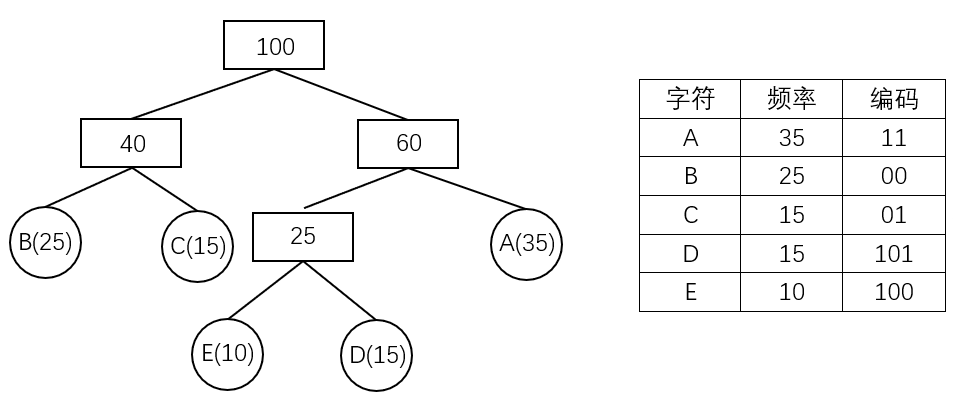
霍夫曼树可用于构造 **最短的前缀编码**,即 **霍夫曼编码(Huffman Code)**,其构造步骤如下:
1. 设需要编码的字符集为:$d_1,d_2,\dots,d_n$,他们在字符串中出现的频率为:$w_1,w_2,\dots,w_n$。
2. 以 $d_1,d_2,\dots,d_n$ 作为叶结点,$w_1,w_2,\dots,w_n$ 作为叶结点的权值,构造一棵霍夫曼树。
3. 规定哈夫曼编码树的左分支代表 0,右分支代表 1,则从根结点到每个叶结点所经过的路径组成的 01 序列即为该叶结点对应字符的编码。
## 应用场景
**数据压缩**:Huffman树常被用于无损数据压缩,特别是在文本和图像等领域。通过根据数据中出现频率来构建Huffman树,将高频字符用较短的编码表示,而低频字符用较长的编码表示,从而实现数据的压缩和解压缩。