


题目
MySQL 索引底层结构(B/B+ 树原理与区别)
解释
类似问题:
1. 索引叶子节点的数据是有序的还是乱序的?
答案
## 索引有哪几种底层实现?
1)**哈希索引**:得益于哈希算法的快速查找特性,不过哈希索引的致命缺点就是无法范围查询。
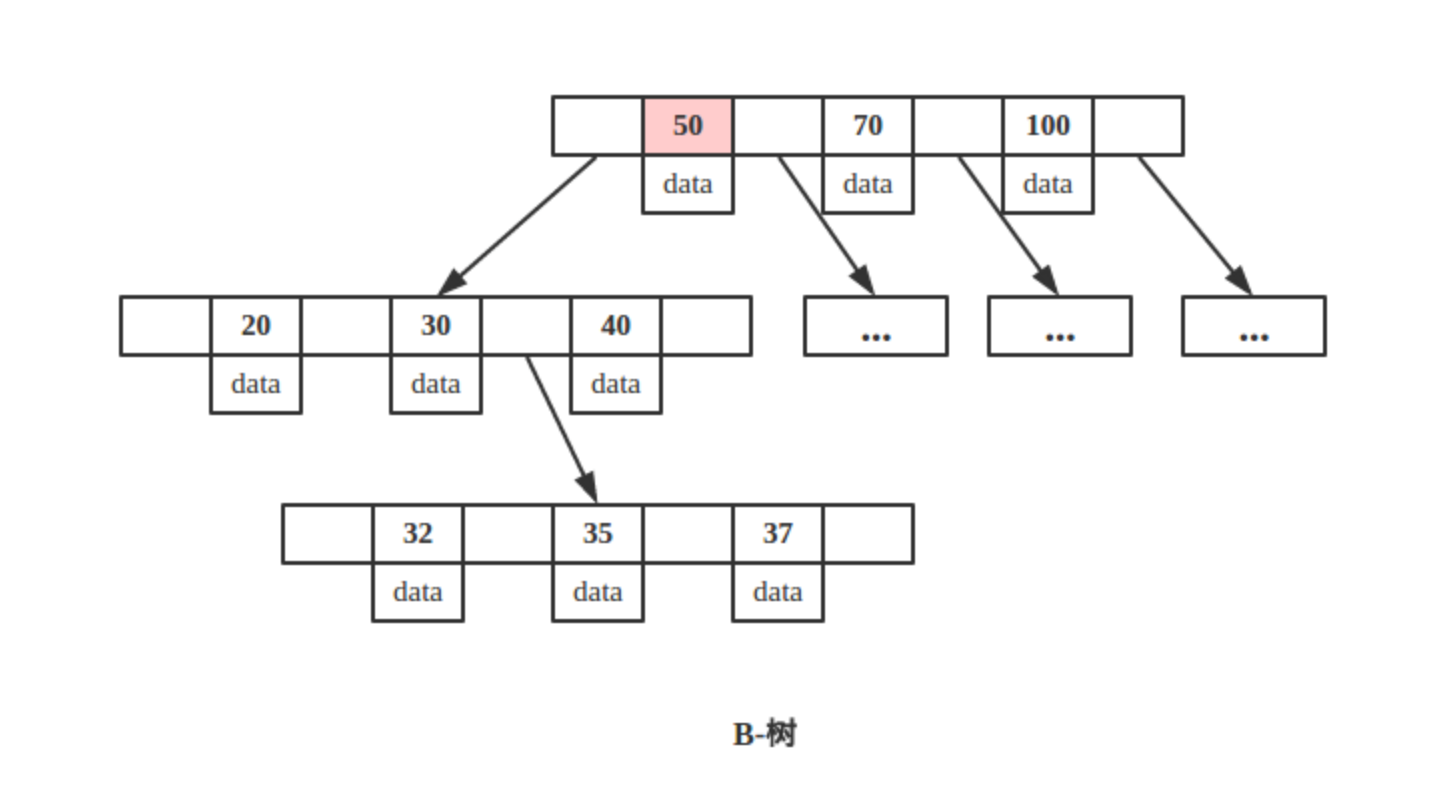
2)**B 树索引**:B 代表平衡(Balance),而不是二叉(Binary)。B 树的特点就是
- 节点同时保存 key 和 data
- B 树在找到具体的数值以后就结束,查询复杂度不稳定,最好为 O(1),数据就在第一层(所以 B 树适合把热点数据存在上层,适用于缓存)
3)**B+ 树索引**:B+ 树索引是目前关系型数据库系统中查找最为常用的索引。B+ 树的特点是
- 非叶子节点只保存 key,而叶子节点保存 key 和 data
- 并且各叶子节点之间通过双向链表按照大小进行连接。也就是说,<u>B+ 树的叶子节点存储真正的记录,而非叶子节点的存在是为了更快速的找到对应记录所在的叶子节点</u>。所以时间复杂度稳定,每次都需要走到叶子节点,时间复杂度为 O(LogN)。
并且由于所有数据都在叶子节点且顺序连接,所以 B+ 树可使用在范围查询,而 B 树无法进行范围查询
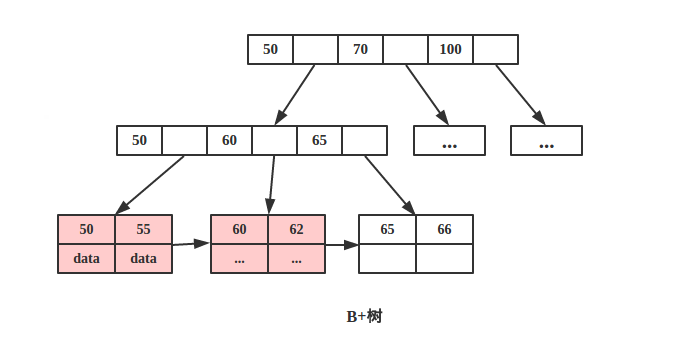
> **B+ 树的叶子节点并不是只存一 `行` 数据,而是存一 `页` 数据!每个页面中有很多行记录**
>
> **InnoDB 不是按行的来操作的,它可操作的最小粒度是页,页加载进内存后才会通过扫描页来获取行记录**。具体查找流程就是先在 B+ 树上通过二分查找找到某页,再进入该页进行查询