


题目
什么是 Kafka?Kafka 的架构和工作原理
答案
## 什么是 Kafka
Kafka 是由 Scala 和 Java 混合编写,最终编译成字节码运行在 JVM 上。严格来说,Kafka 并不是单纯的消息队列,而是一个基于 TCP 协议、使用 NIO(同步非阻塞) 线程模型的 Event Streaming Platform(事件流平台)
流平台具有三个关键功能:
- To **publish** (write) and **subscribe to** (read) streams of events, including continuous import/export of your data from other systems:发布和订阅消息流,这个功能类似于消息队列,这也是 Kafka 也被归类为消息队列的原因。
- To **store** streams of events durably and reliably for as long as you want:根据需要持久可靠地存储事件流(Kafka 会把消息持久化到磁盘,有效避免了消息丢失的风险)
- To **process** streams of events as they occur or retrospectively:在消息发布 or 回溯的时候进行处理
## Kafka 基本架构
Kafka 基本架构:

### Producer
生产者,消息的产生者,是消息的入口。
### Kafka Cluster(集群)
- **Broker**:Broker 就是 Kafka 实例,每个服务器上有一个或多个 Kafka 的实例,我们姑且认为每个 Broker 对应一台服务器。每个Kafka集群内的Broker都有一个**不重复**的编号,如图中的Broker-0、Broker-1等……
- **Topic**:消息的主题,可以理解为消息的分类,Kafka 的数据就保存在 Topic。每个 Broker上可以创建多个 Topic
- **Partition**:对 Topic 进行划分,每个 Topic 可以有多个分区,并且同一 Topic 下的 Partition 可以分布在不同的 Broker 上,这也就表明一个 Topic 可以横跨多个 Broker。**分区的作用主要是做负载均衡,提高 Kafka 的吞吐量;并方便扩展**
- **Replication**:每一个分区都有多个副本。当主分区(**Leader**)故障的时候会选择一个副本(**Follower**)上位,成为 Leader。在Kafka 中默认副本的最大数量是10个,且副本的数量不能大于 Broker 的数量,Follower 和 Leader 绝对是在不同的 Broker,同一机器对同一个分区也只可能存放一个副本(包括自己)。
### Message/Event
每一条发送的消息/事件主体
### Consumer
消费者,即消息的消费方,是消息的出口
### Consumer Group
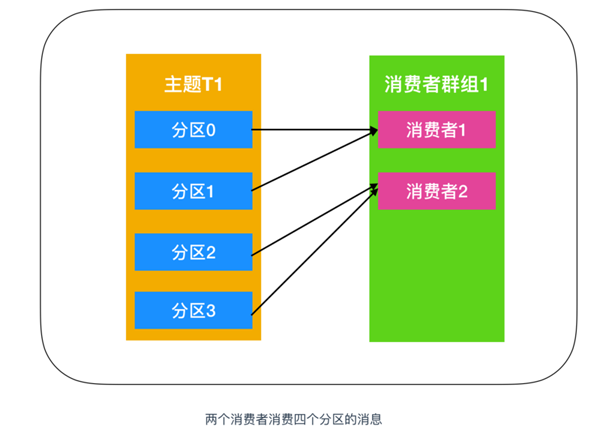
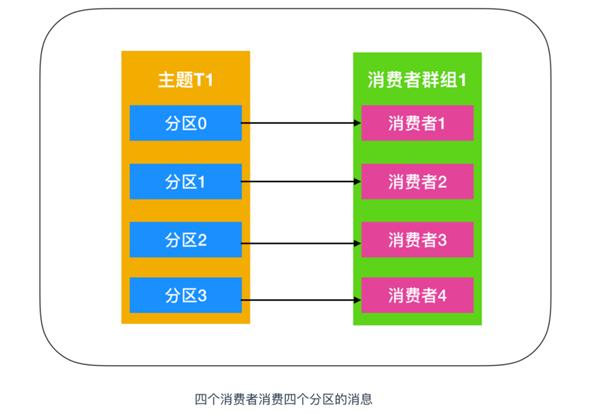
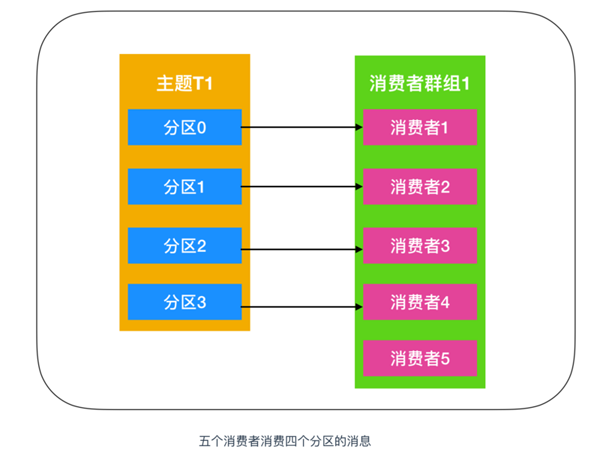
我们可以将多个消费组组成一个消费者组,**在 Kafka 的设计中同一个 Partition 的数据只能被消费者组中的某一个消费者消费(因为 Kafak 只能保证单个 Partition 内消息有序,不能保证全局有序)。同一个消费者组的消费者可以消费同一个 Topic 的不同 Partition 的数据**。
向 Consumer Group 中增加 Consumer 是横向伸缩消费能力的主要方式。我们可以通过增加 Consumer Group 中的 Consumer 来进行水平扩展提升消费能力。这也是为什么建议创建 Topic 时使用比较多的 Partition 数,这样可以在消费负载高的情况下增加 Consumer 来提升性能。另外,**Consumer 的数量不应该比 Partition 多,因为多出来的消费者是空闲的,没有任何帮助**。
### Zookeeper
Kafka 集群依赖 zookeeper 来保存集群的的元信息,来保证系统的可用性
## Kafka 基本工作原理
### 发送消息
Kafka 发送消息的基本步骤如下:
1. Producer:从集群中获取分区(Partition)中的 Leader
2. Producer:发送消息给 Leader
3. Leader:Leader 将消息写入本地文件
4. Followers:Followers 从 Leader 拉取(Pull)消息
5. Followers:Followers 将消息写入本地后向 Leader 发送 ACK 响应
6. Leader:Leader 收到所有分区副本(Followers)的 ACK 响应后,向 Producer 发送 ACK 响应,表示本次消息发送成功
> Kafka 参数 `acks` 的设定不同,上述步骤可能会有所变化
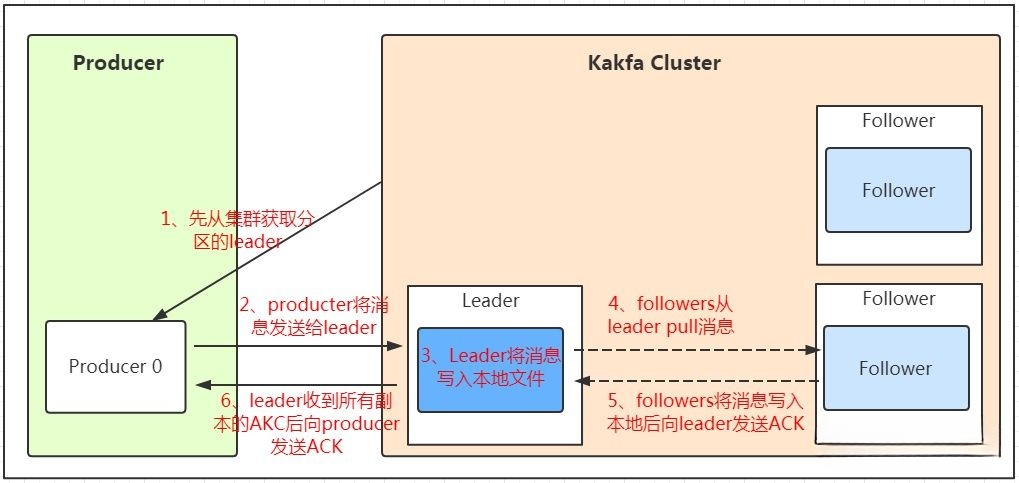
需要注意的一点是,**消息写入 Leader 后,Follower 是主动的去 Leader 进行拉取的(Pull)**!
### 持久化数据
Producer 将数据写入 Kafka 后,集群就需要对数据进行保存了!Kafka 将数据保存在磁盘,可能在我们的一般的认知里,写入磁盘是比较耗时的操作,不适合这种高并发的组件,其实不然,Kafka 初始会单独开辟一块磁盘空间,顺序写入数据,大幅降低磁盘寻道延迟,效率得到很大地提高。
#### Paritition 结构
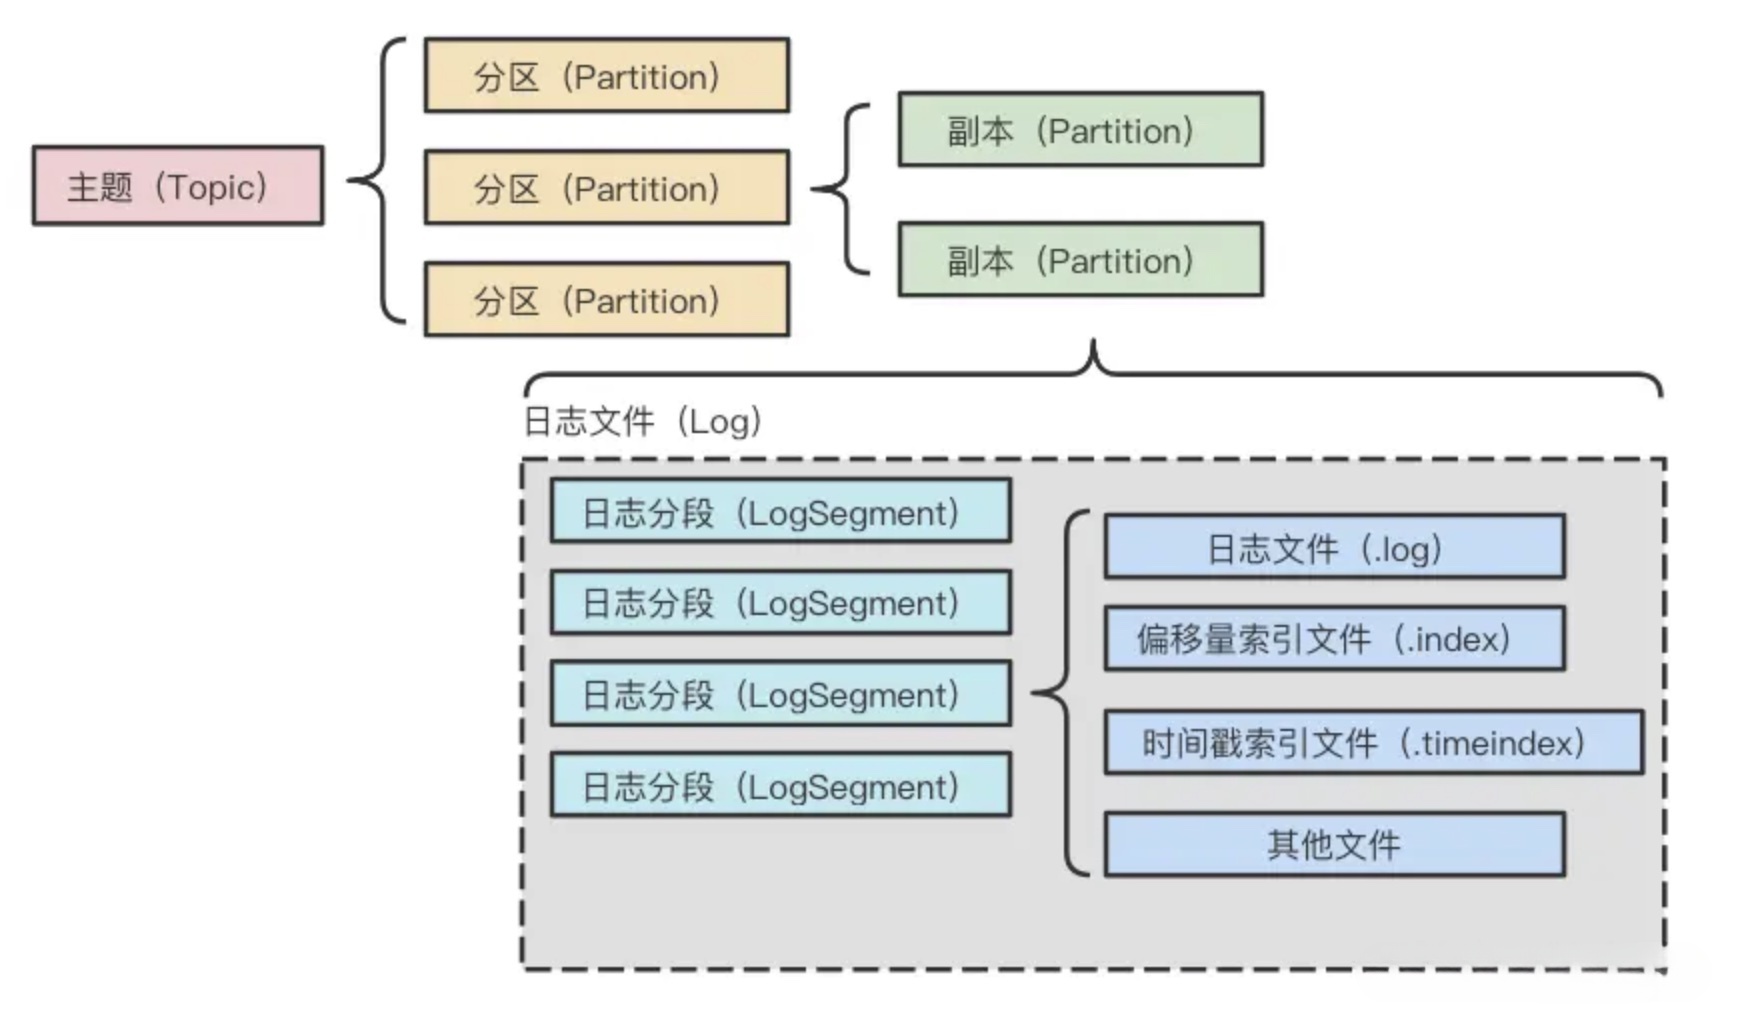
每个 Topic 都可以分为一个或多个 Partition,如果你觉得 Topic 比较抽象,那 Partition 就是比较具体的东西了!**Partition 在服务器上的表现形式就是一个一个的文件夹,每个 Partition 的文件夹下面会有多组 segment 文件**,每组 segment 文件又包含 .index 文件、.log 文件、.timeindex 文件(早期版本中没有)三个文件, **log 文件就实际是存储 message 的地方,而 index 和 timeindex 文件为索引文件,用于检索消息**。
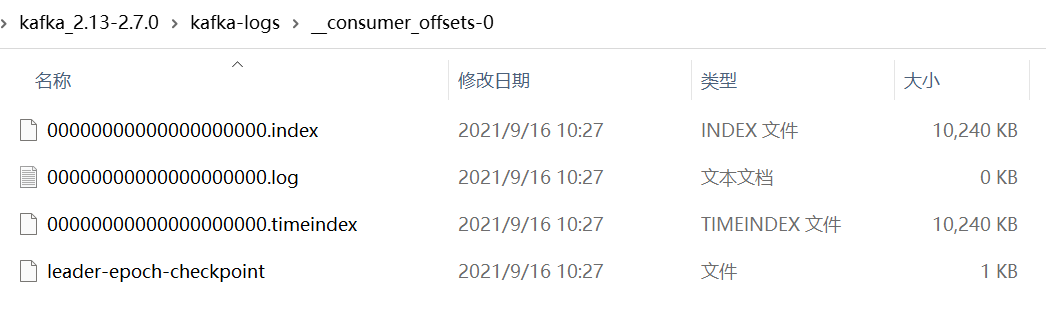
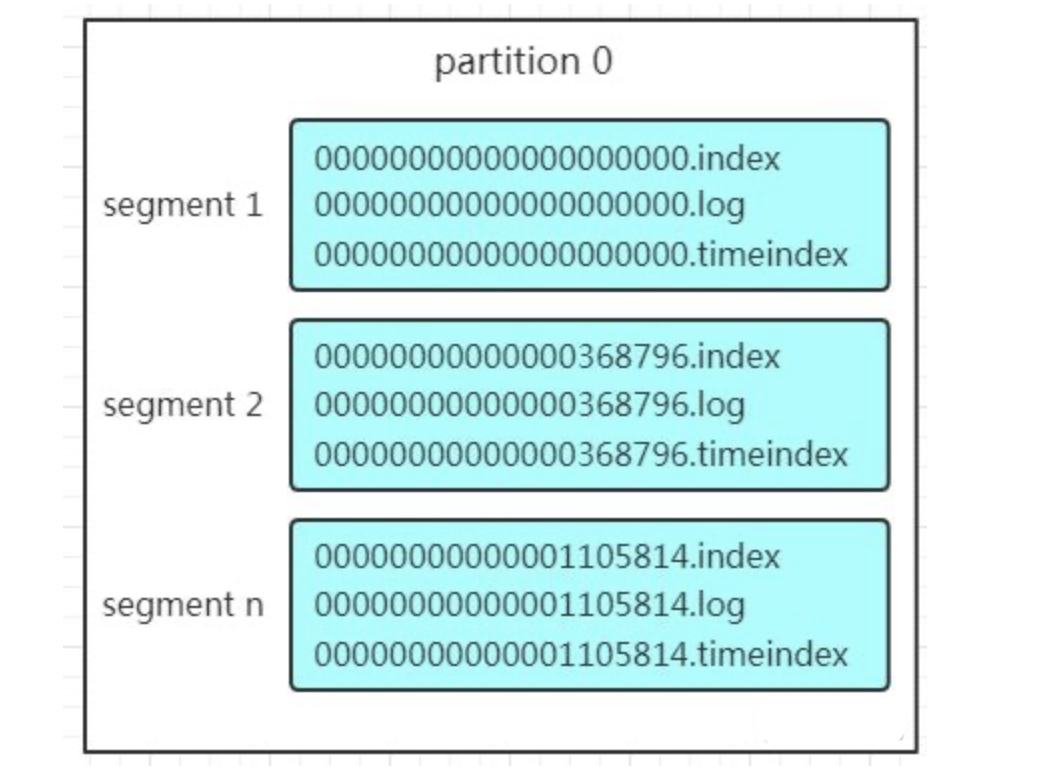
如上图,这个 Partition 有三组 segment 文件,**每个 log 文件的大小是一样的,但是存储的 message 数量是不一定相等的(每条的 message 大小不一致)**。文件的命名是以该 segment 最小 offset 来命名的,如上图 000.log 存储 offset 为 0~368795 的消息,**Kafka 就是利用分段 + 索引的方式来解决查找(消费)效率的问题**。
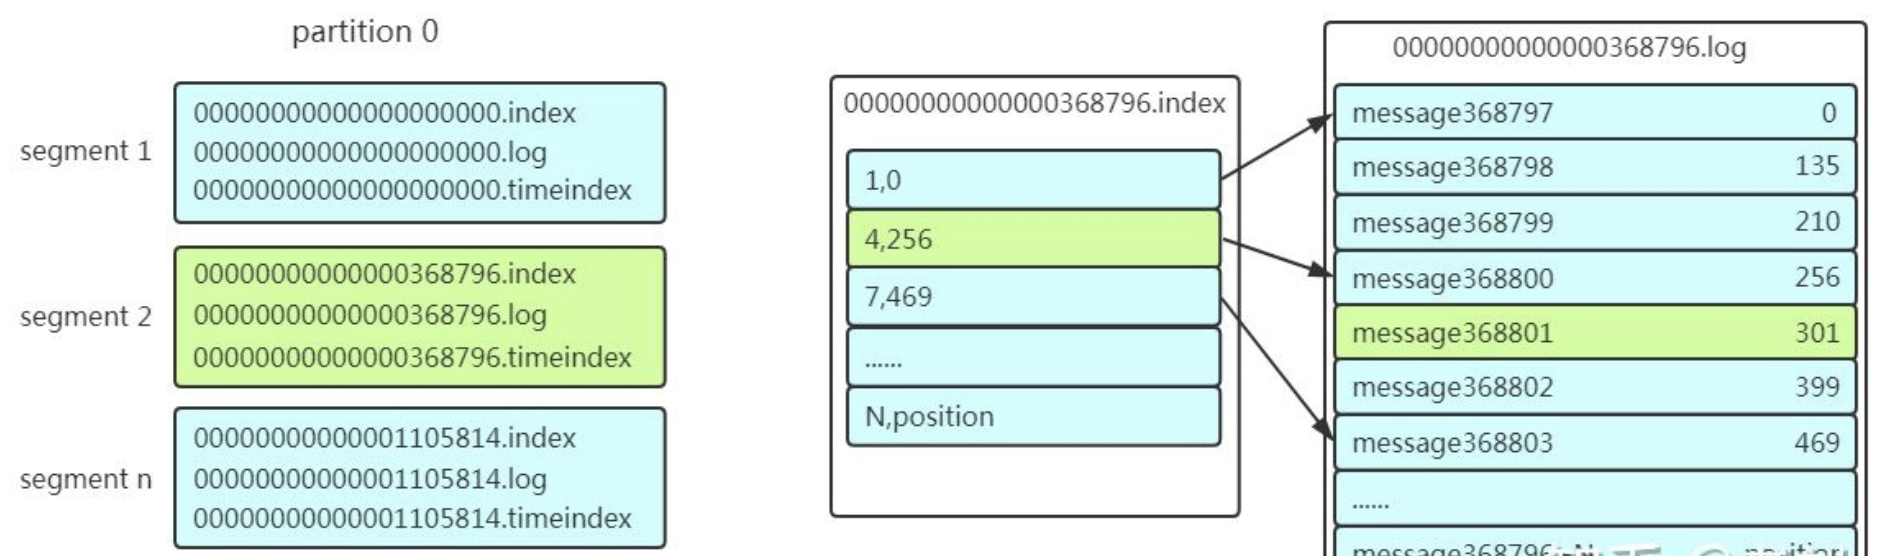
比如需要查找(消费)一个 offset 为 368801 的message
1. 先找到 offset 为 368801 的 message 所在的 segment 文件(利用**二分法**查找)
2. 打开找到的 segment 中的.index文件,找到该 message 对应的索引,根据索引确定 message 存储的物理偏移位置
3. 根据物理偏移位置在 log 文件中查找 message
#### Message 结构
上面说到 log 文件就实际是存储 message 的地方,我们在 Producer 往 Kafka 写入的也是一条一条的 message,**那存储在log 中的 message 是什么样子的呢**?消息主要包含消息体、消息大小、offset、压缩类型……等等!我们重点需要知道的是下面三个:
- offset:offset 是一个占 8 byte 的有序 id 号,它可以**唯一确定每条消息在 parition 内的位置**!
- 消息大小:消息大小占用 4 byte,用于描述消息的大小。
- 消息体:消息体存放的是实际的消息数据(被压缩过),占用的空间根据具体的消息而不一样。
#### 存储(删除)策略
无论消息是否被消费,Kafka 都会保存所有的消息。那对于旧数据有什么删除策略呢?
- 基于时间(time),默认配置是 168 小时(7天)
- 基于大小(size),默认配置是 1073741824
需要注意的是,Kafka 读取特定消息的时间复杂度是 O(1),所以这里删除过期的文件并不会提高 Kafka 的性能!
### 消费消息
消息存储在 log 文件后,消费者就可以进行消费了。**Kafka 采用的是点对点的模式**,即消费者主动的去 Kafka 集群拉取(**Pull**)消息,与 Producer 相同的是,消费者在拉取消息的时候也是**找 Leader**去拉取
多个消费者可以组成一个消费者组(consumer group),每个消费者组都有一个组 id!同**一个消费组者的消费者可以消费【同一 Topic 下不同 Paritition】的数据,但是不会组内多个消费者消费同一 Paritition 的数据**
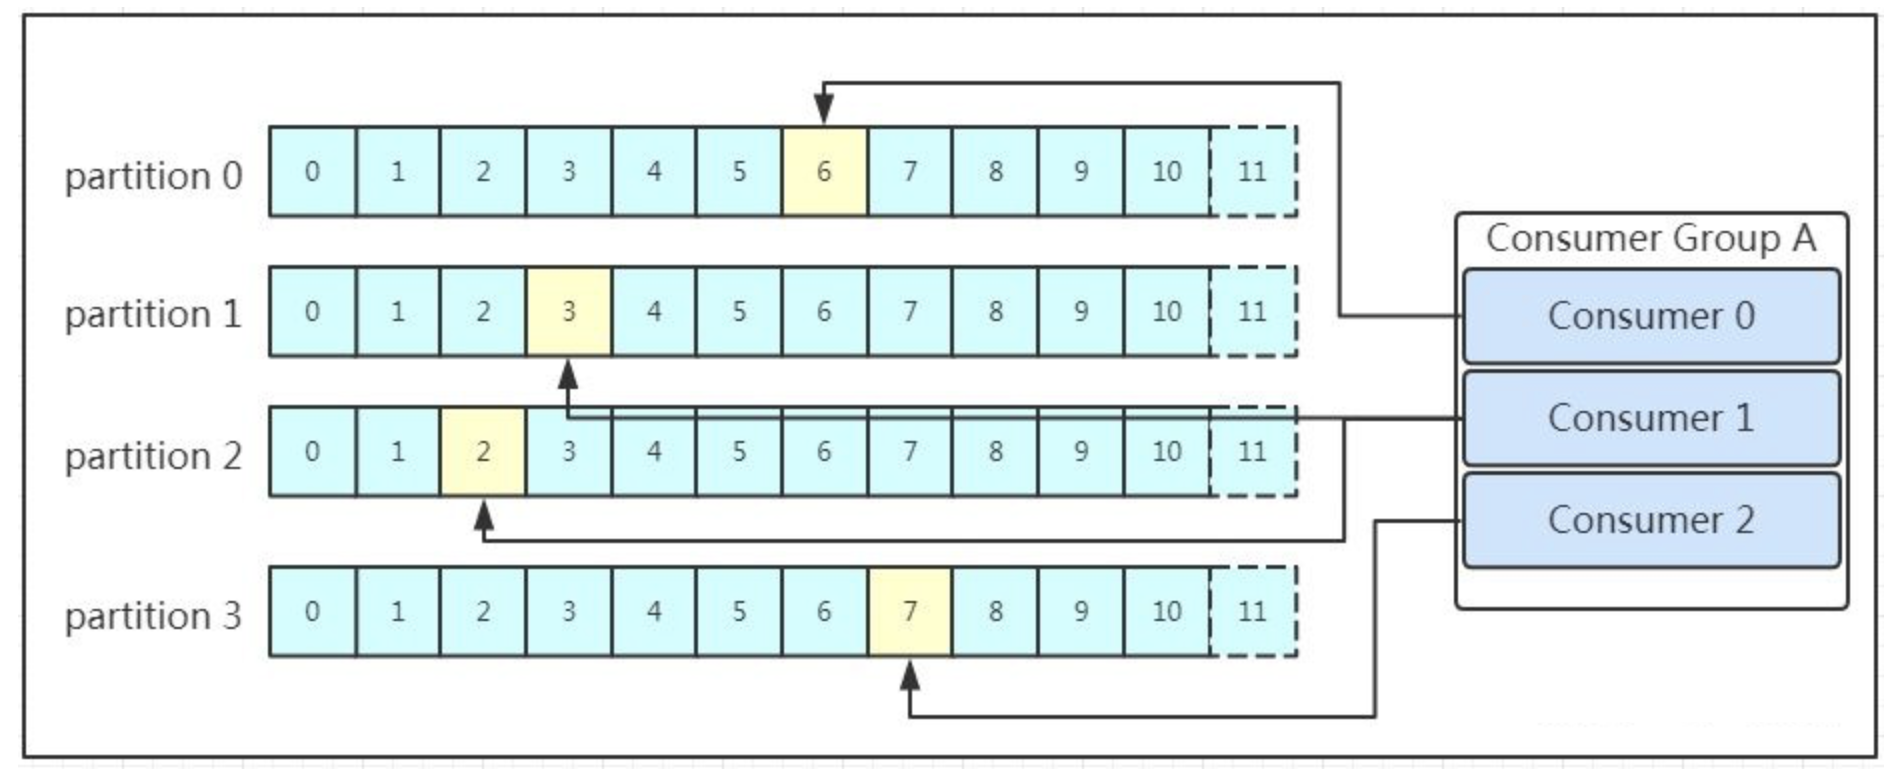
那每个消费者又是怎么记录自己消费的位置(offset)的呢?
- 在早期的版本中,消费者将消费到的 offset 维护到 **Zookeeper** 中,consumer 每间隔一段时间上报一次,这里容易导致重复消费,且性能不好
- 在新的版本中消费者消费到的 offset 已经直接维护在 Kafka 集群的 `__consumer_offsets` 这个 **Topic** 中(The consumer's position is stored as a message in a Topic)