


题目
Redis String 原理和使用场景(分布式锁)
答案
@[toc]
---
String 不仅能够存储字符串,也能够存储数字(整数或浮点数),一个 String 对象最多可以容纳的数据长度是 `512M`。
String 是唯一一个会被其他对象嵌套的对象
## 使用的编码(底层实现)
- `REDIS_ENCODING_INT`:long 类型的整数。该编码的使用场景:如果一个字符串对象保存的是整数值,并且这个整数值可以用 long 类型来表示
> 如果我们向对象执行了一些命令,使得这个对象保存的不再是整数值,而是一个字符串值,那么字符串对象的编码将从 int 变为 raw
- `REDIS_ENCODING_EMBSTR`:embstr 编码的 SDS。该编码的使用场景:如果字符串对象保存的是一个字符串值,并且这个字符串值的长度 **<= 32** 字节;或者是可以用 long double 类型表示的浮点数
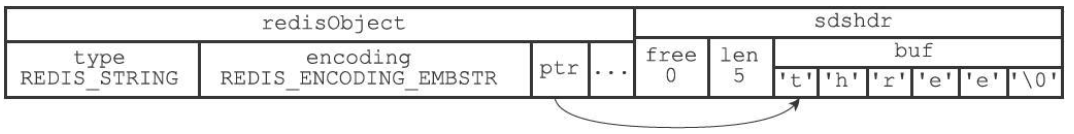
> Redis 没有为 embstr 编码的字符串对象编写任何相应的修改程序,所以 embstr 编码的字符串对象实际上是只读的
>
> 当我们对 embstr 编码的字符串对象执行任何修改命令时,程序会先将对象的编码从 embstr 转换成 raw
- `REDIS_ENCODING_RAW`:SDS。该编码的使用场景:如果字符串对象保存的是一个字符串值,并且这个字符串值的长度 **> 32** 字节
## 常用命令
- `SET KEY VALUE`:设置 key-value 类型的值
- `GET KEY`
- `APPEND KEY VALUE`
- `INCR KEY`(只有 REDIS_ENCODING_INT 可以,将 key 对应的 value 加 1)
- `INCRBY KEY INCREMENT`(只有 REDIS_ENCODING_INT 可以,将 key 对应的 value 加 INCREMENT)
- ......
## 使用场景
### 缓存对象
比如直接缓存整个对象的 JSON,命令例子: `SET user:1 '{"name":"小牛肉", "age":20}'`
### 分布式锁
#### 单机锁和分布式锁的联系与区别?
对于在单机上运行的多线程程序来说,锁本身可以用一个变量表示。变量值为 0 时,表示没有线程获取锁;变量值为 1 时,表示已经有线程获取到锁了。
一个线程调用加锁操作,其实就是检查锁变量值是否为 0。如果是 0,就把锁的变量值设置为 1,表示获取到锁,如果不是 0,就返回错误信息,表示加锁失败,已经有别的线程获取到锁了。
而一个线程调用释放锁操作,其实就是将锁变量的值置为 0,以便其它线程可以来获取锁。
和单机上的锁类似,分布式锁同样可以用一个变量来实现,**但是这个锁变量得被多个客户端都能访问到才行**。也就是需要一个共享存储系统(**外部介质**)存储这个变量
这样一来,我们就可以得出实现分布式锁的两个要求。
- 要求一:分布式锁的加锁和释放锁的过程,涉及多个操作。所以,在实现分布式锁时,我们需要保证这些锁操作的原子性;
- 要求二:共享存储系统保存了锁变量,如果共享存储系统发生故障或宕机,那么客户端也就无法进行锁操作了。在实现分布式锁时,我们需要考虑保证共享存储系统的可靠性,进而保证锁的可靠性。
我们既可以基于单个 Redis 节点来实现,也可以使用多个 Redis 节点(集群)实现。在这两种情况下,锁的可靠性是不一样的。下面来分别说一说
#### 基于单个 Redis 节点实现分布式锁
作为分布式锁实现过程中的共享存储系统,Redis 可以使用键值对来保存锁变量,锁变量名作为键值对的键,而锁变量的值作为键值对的值
因为加锁包含了三个操作(读取锁变量、判断锁变量值以及把锁变量值设置为 X),而这三个操作在执行时需要保证原子性。那怎么保证原子性呢?
在分布式加锁场景下,Redis 可以用 String 对象的 `SET...NX` 命令来设置键值对的值。
注意,这里我们说的 `SET...NX` 命令是 `set key value nx`,而不是 `setnx key value` 命令
Redis 的分布式锁实现有如下两种方案:
1. **利用 `setnx` + `expire` 命令 (错误的做法,setnx 命令在 Redis 2.6.12 版本被抛弃)**
2. **使用 `set key value EX seconds[NX|XX]` 命令(正确做法)**
##### setnx + expire
Redis 的 SETNX 命令,setnx key value,将 key 设置为 value,当键不存在时,才能成功,若键存在,什么也不做,成功返回 1,失败返回 0。**SETNX 实际上就是 SET IF NOT Exists 的缩写**
因为分布式锁还需要超时机制,所以我们利用 expire 命令来设置,所以利用 setnx+expire 命令的核心代码如下:
```java
public boolean tryLock(String key,String requset,int timeout) {
Long result = jedis.setnx(key, requset);
// result = 1时,设置成功,否则设置失败
if (result == 1L) {
return jedis.expire(key, timeout) == 1L;
}
else {
return false;
}
}
```
实际上上面的步骤是有问题的,**setnx 和 expire 是分开的两步操作,不具有原子性**,如果执行完第一条指令应用异常或者重启了,锁将无法过期。
一种改善方案就是使用 Lua 脚本来保证原子性 (包含 setnx 和 expire 两条指令)
```java
public boolean tryLock_with_lua(String key, String UniqueId, int seconds) {
String lua_scripts = "if redis.call('setnx',KEYS[1],ARGV[1]) == 1 then" + "redis.call('expire',KEYS[1],ARGV[2]) return 1 else return 0 end";
List keys = new ArrayList<>();
List values = new ArrayList<>();
keys.add(key);
values.add(UniqueId);
values.add(String.valueOf(seconds));
Object result = jedis.eval(lua_scripts, keys, values);
// 判断是否成功
return result.equals(1L);
}
```
##### set key value EX seconds [NX|XX]
Redis在 2.6.12 版本开始,为 SET 命令增加一系列选项:
```redis
SET key value[EX seconds][PX milliseconds][NX|XX]
```
- **EX seconds:设定过期时间,单位为秒**
- PX milliseconds:设定过期时间,单位为毫秒
- NX:仅当 key 不存在时设置值
- XX:仅当 key 存在时设置值
- set 命令的 nx 选项,就等同于 setnx 命令
具体来说,就是这个 `SET key value NX` 命令在执行时会判断键值对是否存在,如果不存在,就设置键值对的值,如果存在,就不做任何设置。
伪代码如下:
```java
if(jedis.set(key_resource_id, lock_value, "NX", "EX", 100s) == 1){ // 加锁
try {
do something // 业务处理
} catch(){
}
finally {
jedis.del(key_resource_id); // 释放锁
}
}
```
不过这个方案还是可能存在问题:
- 问题一:**锁过期释放了,业务还没执行完**。假设线程 a 获取锁成功,一直在执行临界区的代码。但是 100s 过去后,它还没执行完。但是,这时候锁已经过期了,此时线程 b 又请求过来。显然线程 b 就可以获得锁成功,也开始执行临界区的代码。那么问题就来了,临界区的业务代码都不是严格串行执行的了
> 锁的过期时间,绝对不能想当然的设置一个值。假设线程 A 在执行某个业务时加锁成功并设置锁过期时间。但该业务执行时间过长,业务的执行时间超过了锁过期时间,那么在业务还没执行完时,锁就自动释放了。接着后续线程就可以获取到锁,又来执行该业务。就会造成线程 A 还没执行完,后续线程又来执行,导致同一个业务逻辑被重复执行。
>
> 因此对于锁的超时时间,需要结合着业务执行时间来判断,**让锁的过期时间大于业务执行时间**。
>
> 上面的方案是一个基础解决方案,但是仍然是有问题的。业务执行时间的影响因素太多了,无法确定一个准确值,只能是一个估值。无法百分百保证业务执行期间,锁只能被一个线程占有。
>
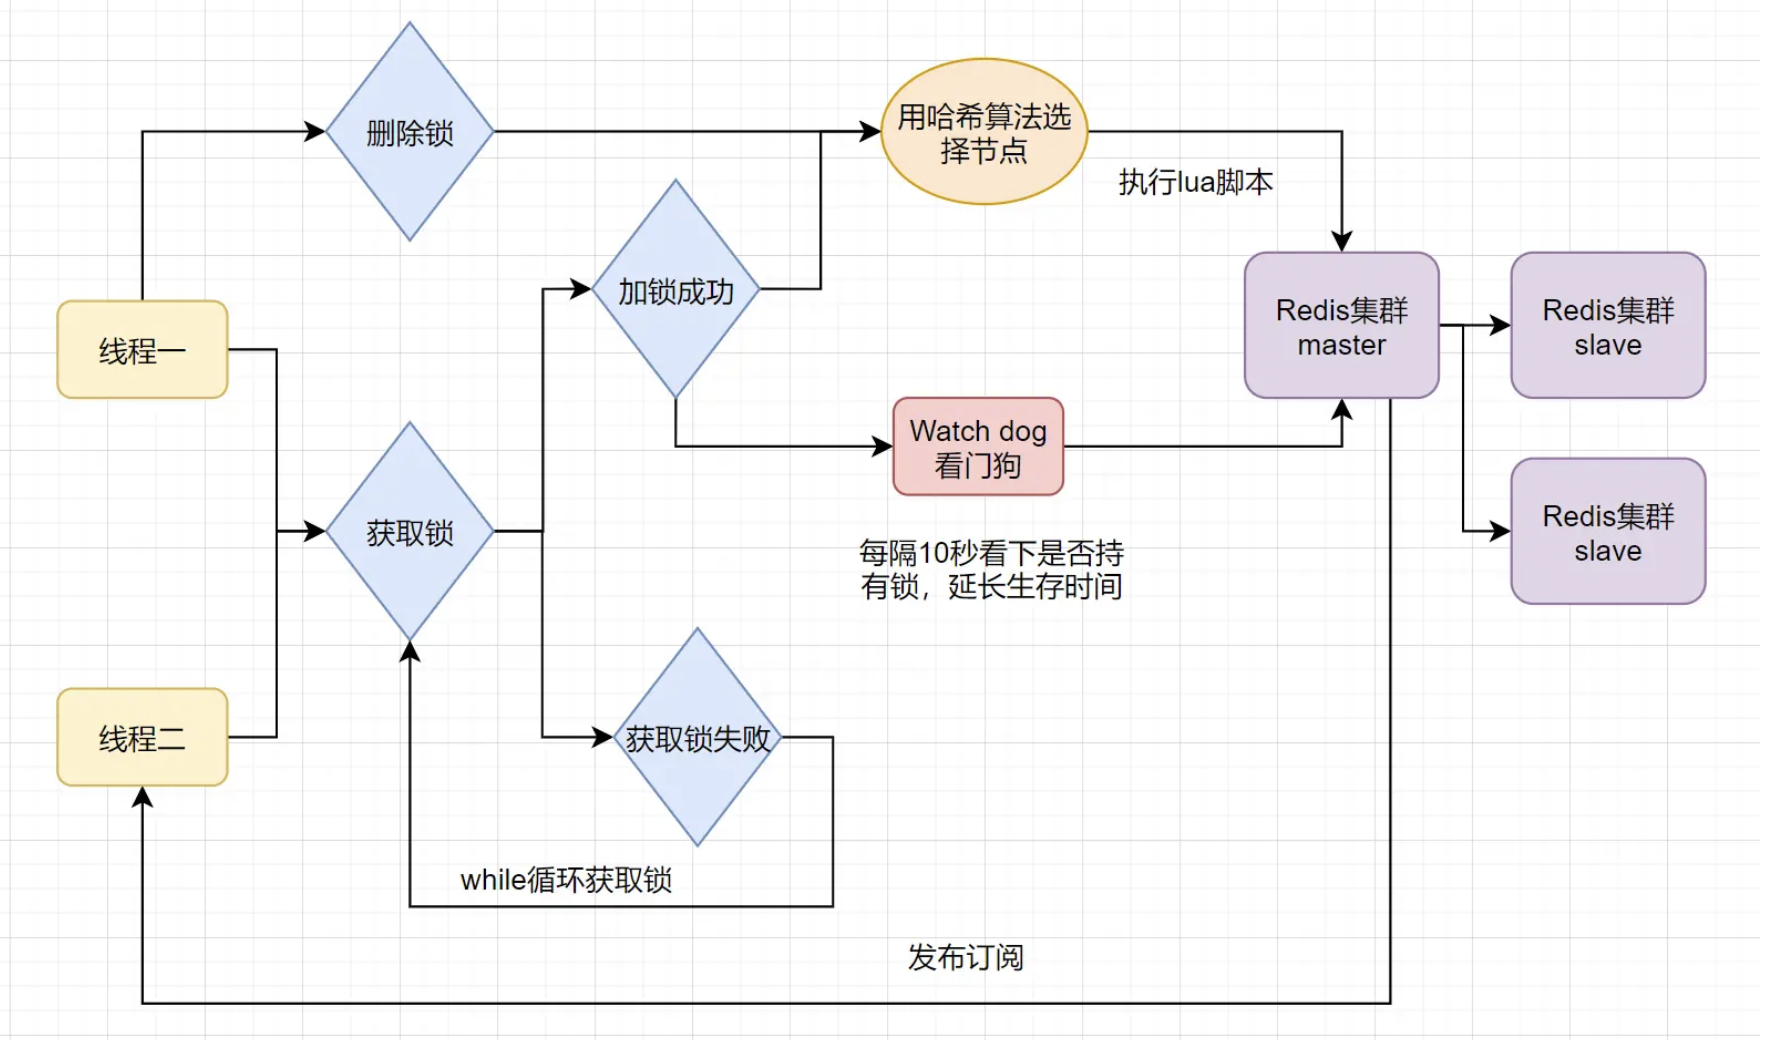
> 如想保证锁的过期时间一定大于业务执行时间的话,可以在创建锁的同时创建一个**守护线程**,**每隔一段时间检查锁是否还存在,存在则对锁的过期时间延长,防止锁过期提前释放**。当业务执行完,释放锁后,再关闭守护线程。 这种实现思想可以用来解决锁续期(**Redisson** 框架就是这么做的)。
>
> 我们一起来看下 Redisson 底层原理图吧:
>
> 
- 问题二:**锁被别的线程误删**。假设线程 a 执行完后,去释放锁(`del`) 。但是它不知道当前的锁可能是线程 b 持有的(线程 a 去释放锁时,有可能过期时间已经到了,此时线程 b 进来占有了锁)。那线程 a 就把线程 b 的锁释放掉了,但是线程 b 临界区业务代码可能都还没执行完呢
> 解决方案:
>
> 既然锁可能被别的线程误删,那我们给 **`value`** 值设置一个标记当前线程唯一的随机数,在删除的时候,校验一下,不就 OK 了嘛。伪代码如下:
>
> ```csharp
> if(jedis.set(key_resource_id, uni_request_id, "NX", "EX", 100s) == 1){ //加锁
> try {
> do something //业务处理
> } catch(){
>
> } finally {
> // 判断是不是当前线程加的锁,是才释放
> if (uni_request_id.equals(jedis.get(key_resource_id))) {
> jedis.del(lockKey); //释放锁
> }
> }
> }
> ```
>
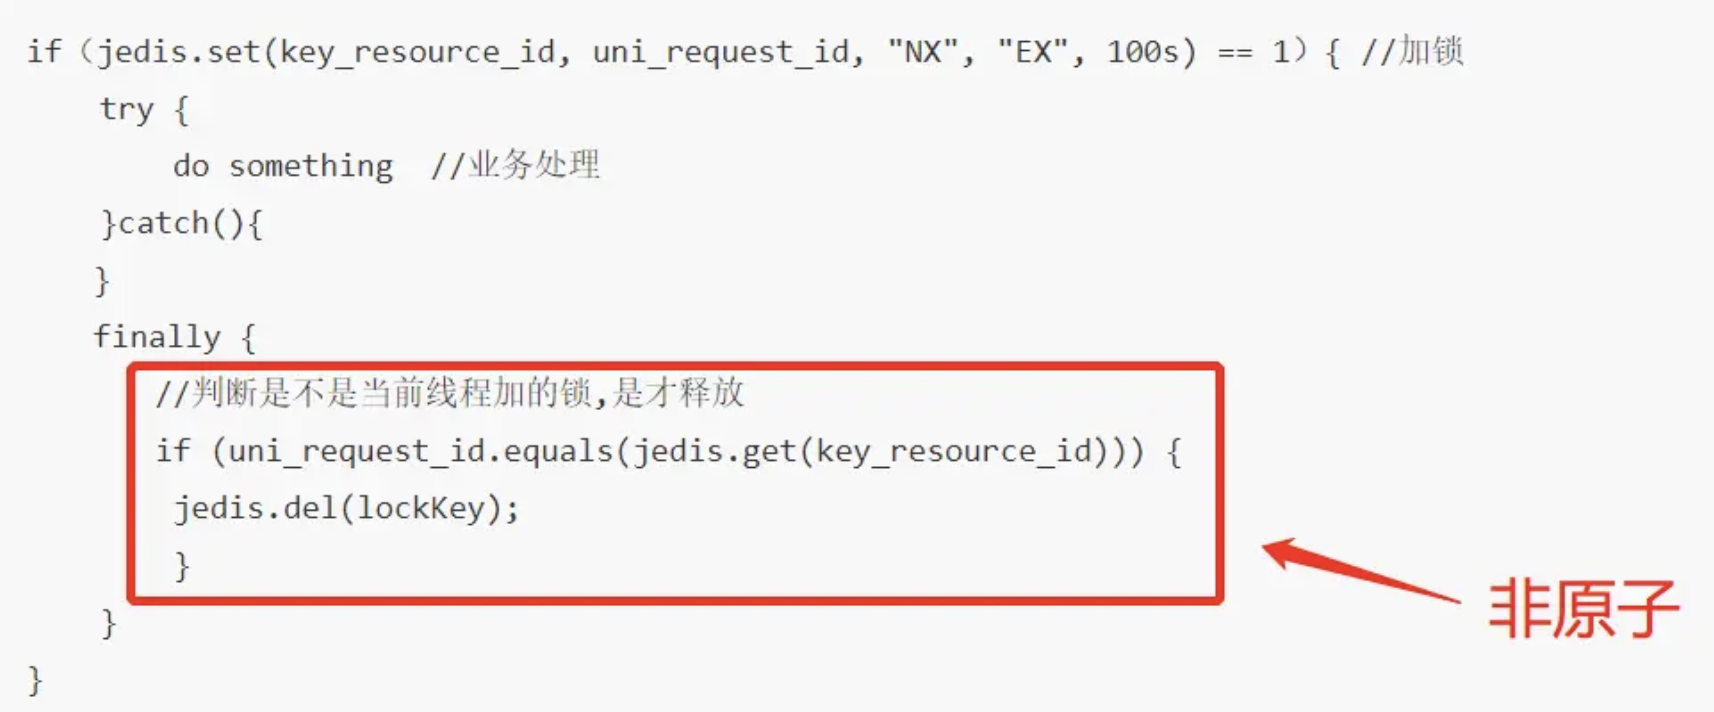
> 在这里,**判断是不是当前线程加的锁**和**释放锁**不是一个原子操作。如果调用jedis.del()释放锁的时候,可能这把锁已经不属于当前客户端,会解除他人加的锁。
>
> 
>
> 为了更严谨,一般也是用 lua 脚本代替。lua 脚本如下:
>
> ```lu a
> if redis.call('get',KEYS[1]) == ARGV[1] then
> return redis.call('del',KEYS[1])
> else
> return 0
> end;
> ```
#### 基于多个 Redis 节点实现分布式锁
官方文档:[https://redis.io/docs/reference/patterns/distributed-locks/](https://redis.io/docs/reference/patterns/distributed-locks/)
以上,**我们只用了一个 Redis 实例来保存锁变量,如果这个 Redis 实例发生故障宕机了,那么锁变量就没有了**。此时,客户端也无法进行锁操作了,这就会影响到业务的正常执行。所以,我们在实现分布式锁时,还需要保证锁的可靠性,这就要提到基于多个 Redis 节点(集群)实现分布式锁的方式了。
为了避免 Redis 实例故障而导致的锁无法工作的问题,Redis 的开发者 Antirez 提出了【**分布式锁算法 Redlock**】。
Redlock 算法的基本思路,是让客户端和多个独立的 Redis 实例依次请求加锁,如果客户端能够和【半数以上】的实例成功地完成加锁操作,那么我们就认为,客户端成功地获得分布式锁了,否则加锁失败。
这样一来,**即使有单个 Redis 实例发生故障,因为锁变量在其它实例上也有保存,所以,客户端仍然可以正常地进行锁操作,锁变量并不会丢失**。
我们来具体看下 Redlock 算法的执行步骤。Redlock 算法的实现需要有 N 个独立的 Redis 实例。接下来,我们可以分成 3 步来完成加锁操作:
1)客户端获取当前时间
2)第二步是,客户端按顺序依次向 N 个 Redis 实例执行加锁操作。这里的加锁操作和在单实例上执行的加锁操作一样,使用 SET 命令,带上 NX,EX/PX 选项,以及带上客户端的唯一标识。
如果某个 Redis 实例发生故障了,为了保证在这种情况下,Redlock 算法能够继续运行,我们需要给加锁操作设置一个超时时间。如果客户端在和一个 Redis 实例请求加锁时,一直到超时都没有成功,那么此时,客户端会和下一个 Redis 实例继续请求加锁。加锁操作的超时时间需要远远地小于锁的有效时间,一般也就是设置为几十毫秒。
3)一旦客户端完成了和所有 Redis 实例的加锁操作,客户端就要计算整个加锁过程的总耗时。客户端只有在满足下面的这两个条件时,才能认为是加锁成功:
- 条件一:客户端从超过半数(大于等于 N/2+1)的 Redis 实例上成功获取到了锁
- 条件二:客户端获取锁的总耗时没有超过锁的有效时间
在满足了这两个条件后,我们需要重新计算这把锁的有效时间,计算的结果是锁的最初有效时间减去客户端为获取锁的总耗时。如果锁的有效时间已经来不及完成共享数据的操作了,我们可以释放锁,以免出现还没完成数据操作,锁就过期了的情况。
如果客户端在和所有实例执行完加锁操作后,没能同时满足这两个条件,那么,客户端向所有 Redis 节点发起释放锁的操作。
这样一来,只要 N 个 Redis 实例中的半数以上实例能正常工作,就能保证分布式锁的正常工作了。所以,在实际的业务应用中,如果你想要提升分布式锁的可靠性,就可以通过 Redlock 算法来实现。
#### 分布式锁的其他实现方案
1)数据库
- 锁表
- 没有锁失效时间,如果解锁失败,就会导致锁记录永远留在数据库中,造成死锁
- 该锁不可重入,因为它不认识请求方是不是当前占用锁的线程
- 当前数据库是单点,一旦宕机,锁机制就会完全崩坏
- 悲观锁(`select ... for update`)
- 乐观锁(`update ... set xxx, version = version + 1 where id = xxx and verseion = xxx`)
2)Zookeeper
### 计数器
因为 Redis 处理命令是单线程,所以执行命令(`INCR`,`INCRBY`)的过程是原子的。因此 String 数据类型适合计数场景,例如:文章的阅读量、微博点赞数等、允许一定的延迟,先写入 Redis 再定时同步到数据库
```bash
# 初始化 id 为 1001 这个帖子的阅读量
> SET aritcle:readcount:1001 0
OK
# id 为 1001 这个帖子的阅读量 +1
> INCR aritcle:readcount:1001
(integer) 1
```
### 限流
限流其实也是计数器的一种应用,即**记录请求的次数,当达到某个阈值的时候就限制访问**