


题目
如何拆解首 Token 延迟、模型生成时间、工具耗时和排队时间?
答案
从用户点击提交开始记录时间,区分网关接收、任务排队、上下文准备、模型请求、首个可展示内容、工具调用和最终完成等节点。
模型服务报告的首 Token 延迟通常不包含应用排队和检索时间。用户体感应从提交请求算起,而且模型先返回工具参数时,并不等于用户已经看到答案。
多轮 Agent 的总耗时还包括反复调用模型和工具的时间。并行步骤应按关键路径分析,不能简单把所有 Span 耗时相加。
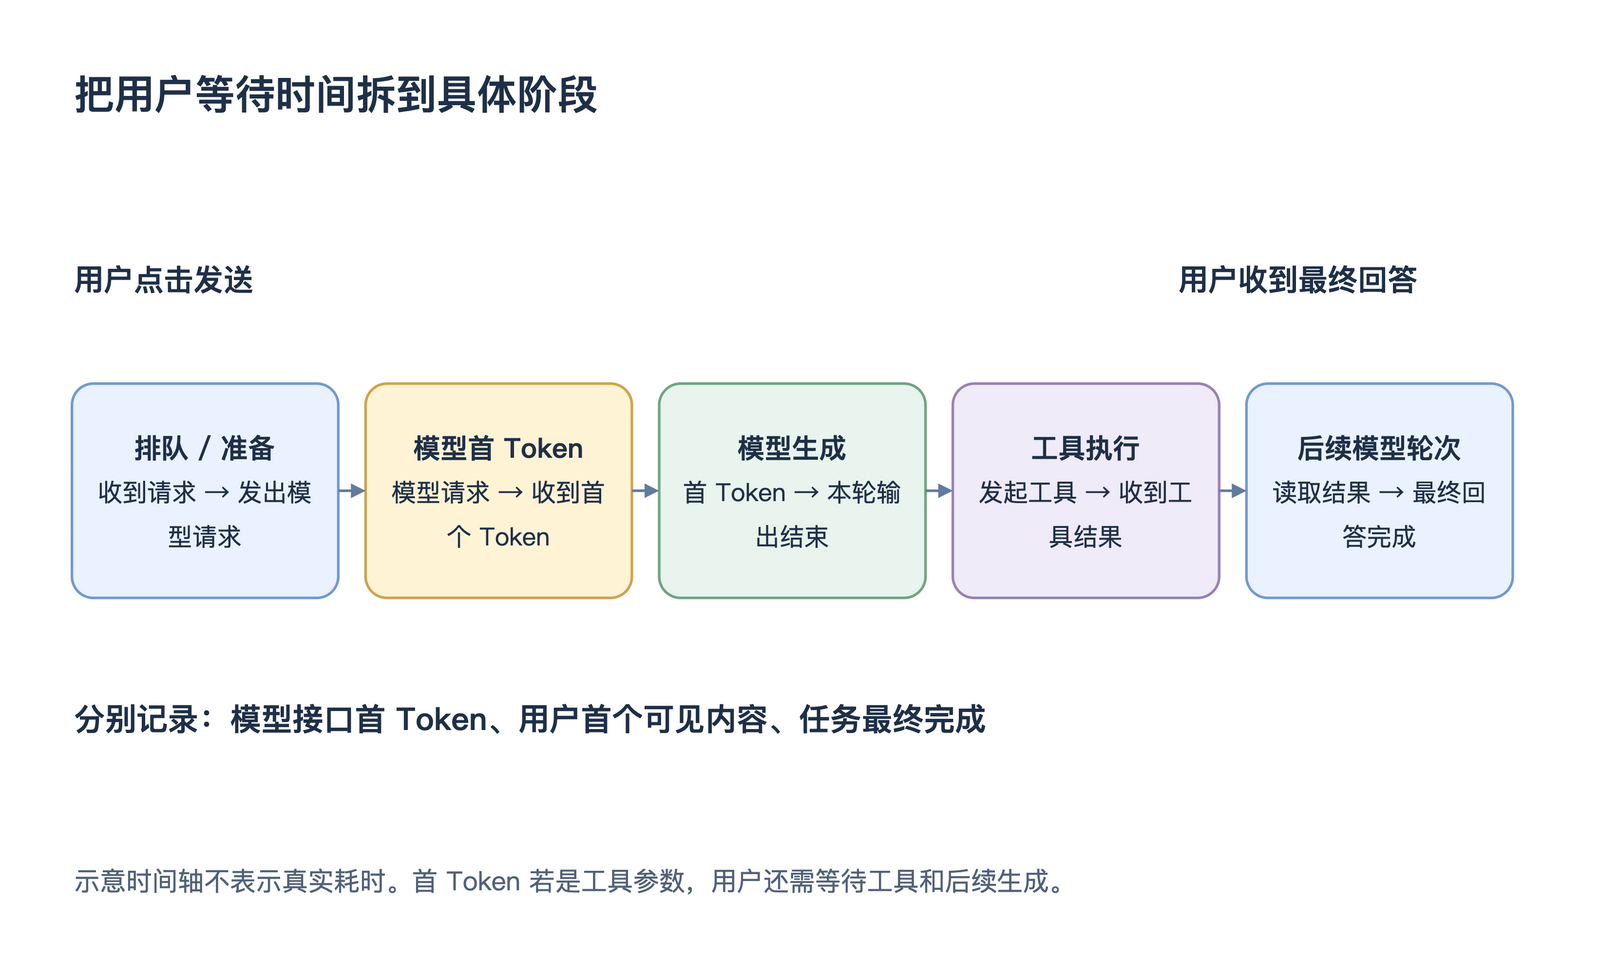
按阶段统计中位数和高分位延迟,再决定优化对象:排队慢就查容量和调度,检索慢就查索引,工具慢就查下游,模型生成慢再考虑模型、输出长度和调用轮次。只优化首 Token 不一定能缩短任务完成时间。