


题目
多路检索的分数尺度不同时,如何融合、去重和排序?
答案
不同检索器的分数含义不同,例如 BM25 分数和向量相似度不能直接相加。可先做分数归一化与校准,也可使用只依赖排名的 RRF。
RRF 的基本思路是:某文档在多个列表中排名越靠前,融合分数越高。常见形式为 `Σ 1 / (k + rank)`,其中 `k` 是平滑参数,需要按数据调试。
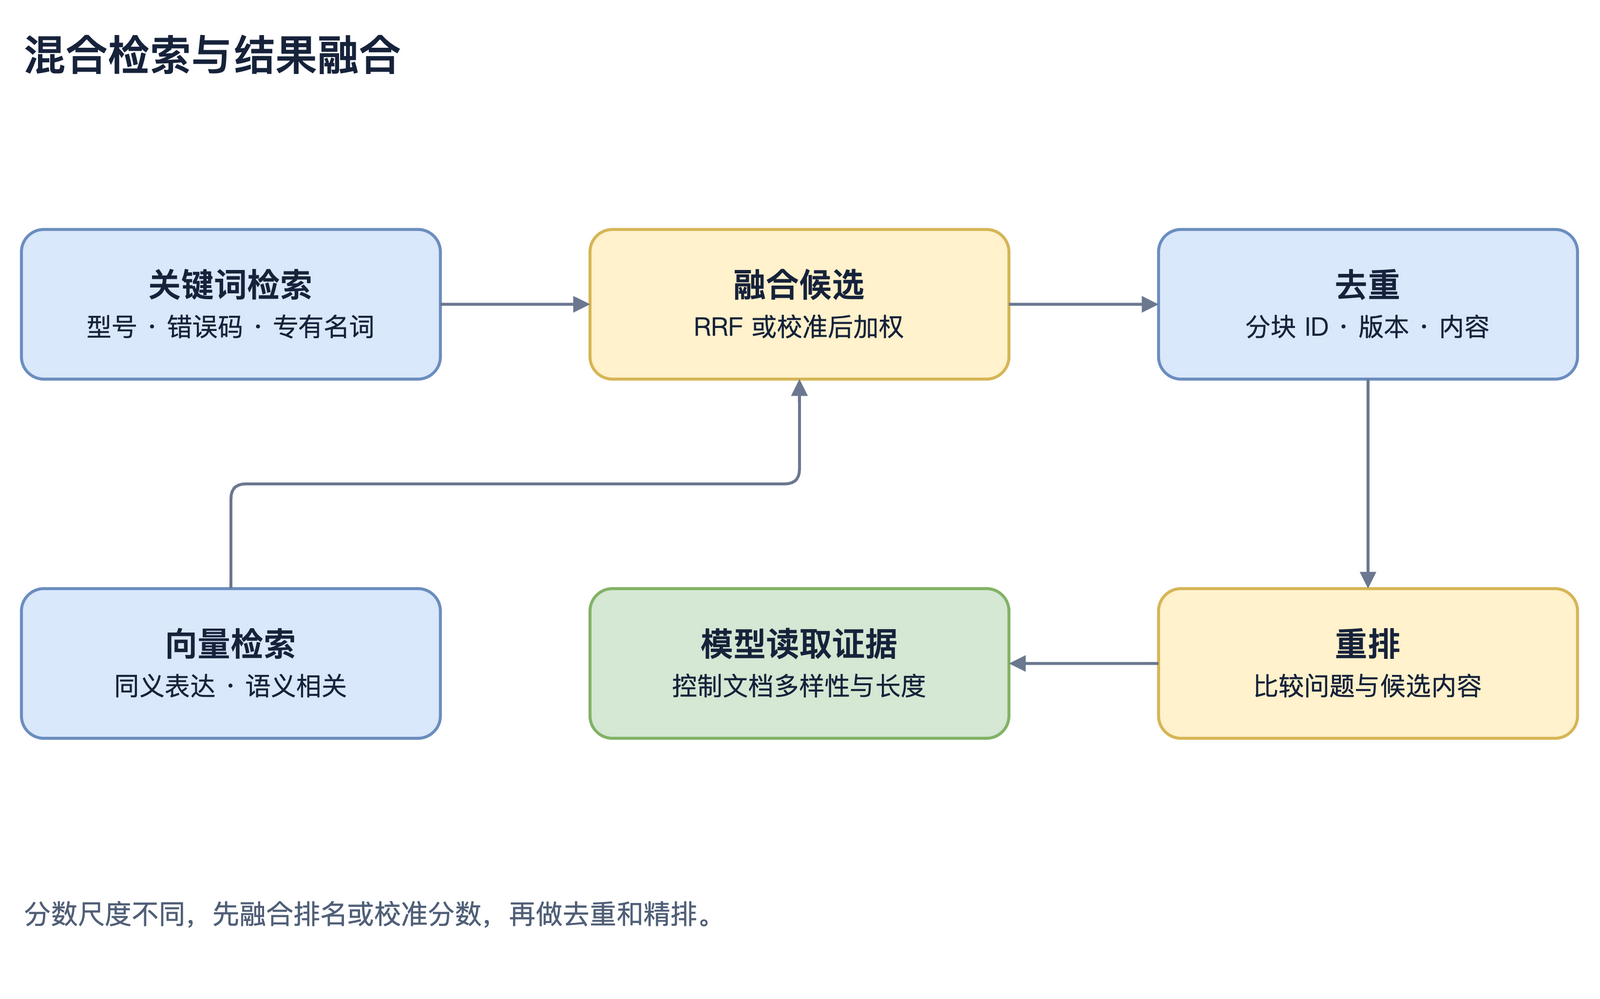
融合前后按稳定的文档或分块 ID 去除重复,再处理内容近似的重复。不能仅因标题相同就合并不同版本的文档。
随后可用重排模型比较“问题—候选内容”的相关性,并限制同一文档占用过多位置。最终仍通过标注样本评估召回和答案正确率,融合分数本身不等于事实可信度。