


Java 线程基础知识
@[toc]
---
## Java 线程和操作系统的线程有啥区别?
操作系统线程有两种实现方式:
1)**在用户空间中实现线程**
在<u>早期</u>的操作系统中,所有的线程都是在<u>用户空间</u>下实现的,操作系统只能看到线程所属的进程,而不能看到线程。
在这种实现方式下,我们需要自己定义线程的数据结构、创建、销毁、调度和维护等,这些线程运行在操作系统的某个进程内,然后操作系统直接对进程进行调度。

2)**在内核空间中实现线程**
现在几乎所有的现代操作系统,包括 Windows、Linux、Mac OS X 和 Solaris 等,都支持<u>内核线程</u>。
每个内核线程可以视为内核的一个分身,这样操作系统就有能力同时处理多件事情,<u>支持多线程的内核就叫做多线程内核</u>(Multi-Threads Kernel)。

在这种实现方式下,我们可以直接使用操作系统中已经内置好的线程,线程的创建、销毁、调度和维护等,都是直接由操作系统的内核来实现,我们只需要使用系统调用就好了,不需要像用户级线程那样自己设计线程调度等。
> 用户线程和内核线程的对应关系,就称为 ”<u>线程模型</u>“,有以下三种:
>
> - 多对一线程模型
>
> 
>
> - 一对一线程模型
>
> 
>
> - 一对多线程模型
>
> 
<br>
对于 Java 来说,<u>在 JDK 1.2 之前</u>,Java 线程是基于称为 "绿色线程"(Green Threads)的用户级线程实现的,也就是说设计者们为 JVM 开发了自己的一套线程库或者说线程管理机制。
而<u>在 JDK 1.2 及以后</u>,JVM 选择了更加稳定且方便使用的操作系统原生的内核级线程,通过系统调用,将线程的调度交给了操作系统内核。即 Java 的线程很大程度上依赖于操作系统采用什么样的线程模型,这点在不同的平台上没有办法达成一致,JVM 规范中也并未限定 Java 线程需要使用哪种线程模型来实现,可能是一对一,也可能是多对多或多对一。
总结来说,<u>JDK 1.2 后 Java 线程的本质,其实就是操作系统中的线程,其线程库(线程库就是为开发人员提供创建和管理线程的一套 API)和线程模型很大程度上依赖于操作系统(宿主系统)的具体实现,比如在 Windows 中 Java 就是基于 Win32 线程库来管理线程,且 Windows 采用的是一对一的线程模型</u>。
## Java 如何创建和启动线程
首先需要清楚线程类 `Thread` 和 任务类 `Runnable`、`Callable` 的概念:
**线程是载体,而任务才是线程具体做的事情**。
### Runnable 和 Callable 的区别
线程类 `Thread` 实现了 `Runnable` 接口,Runnable 接口中只包含一个方法,就是 `run` 抽象方法,Thread 实现了这个方法,我们创建线程的时候可以重写这个方法在其中定义该线程需要执行的任务


`Runnable` 定义的 run 方法是没有返回值的,而 Callable 接口定义的 call 方法是拥有返回值的,而且能够抛出异常。所以对于需要获取任务执行结果的线程来说,可以使用 Callable 接口。

### 创建线程的三种基本方法
> 除了这三种基本方法,还可以使用线程池来创建
1)**直接【继承】Thread 类**
`Thread` 类实现了 `Runnable` 接口,我们可以通过继承 `Thread` 类并重写 run 方法来创建一个自定义线程
示例代码:
```java
// 自定义线程对象
class Thread1 extends Thread {
@Override
public void run() {
// 线程需要执行的任务
......
}
}
// 创建线程对象
Thread1 t1 = new Thread1();
```
2)**Thread + 实现 Runnable 接口**
假如有多个线程,这些线程执行的任务都是一样的,那按照上述方法一的话我们就得写很多重复代码
所以,我们可以把线程执行的任务与线程本身分离开来。<u>Thread 提供了包含 `Runnable` 类型参数的构造函数</u>
示例代码:
```java
class MyRunnable implements Runnable {
@Override
public void run() {
// 线程需要执行的任务
......
}
}
// 创建任务类对象
MyRunnable runnable = new MyRunnable();
// 创建线程对象
Thread t2 = new Thread(runnable);
```
上述代码使用匿名内部类的简化版本如下:
```java
// 创建任务类对象
Runnable runnable = new Runnable() {
public void run(){
// 要执行的任务
......
}
};
// 创建线程对象
Thread t2 = new Thread(runnable);
```
3)**Thread + 实现 Callable 接口**
<u>Thread 类的构造函数里并不接收 `Callable` 类型的参数</u>。
所以,<u>我们需要把 Callable 包装一下,包装成 Runnable 类型</u>,这样就能传给 Thread 构造函数了。
为此,`FutureTask` 成为了最好的选择。

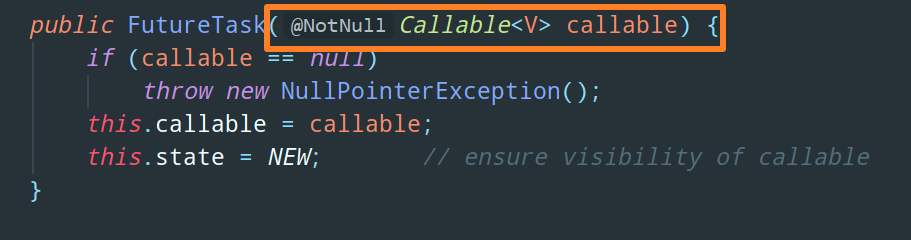
<u>FutureTask 间接继承了 `Runnable` 接口并且构造参数是 `Callable` 类型</u>,因此它也可以看作是一个 Runnable 对象,可以作为参数传入 Thread 类的构造函数。
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/image-20220621180813263.png" style="zoom:67%;" />
举个例子:
```java
class MyCallable implements Callable<Integer> {
@Override
public Integer call() throws Exception {
// 要执行的任务
......
return 100;
}
}
// 将 Callable 包装成 FutureTask
MyCallable callable = new MyCallable();
FutureTask<Integer> task = new FutureTask<>(callable);
// 创建线程对象
Thread t3 = new Thread(task);
```
另外,FutureTask 还间接继承了 Future 接口,并且,这个 Future 接口定义了可以获取 call() 返回值的方法 `get`:(<u>这个方法会阻塞住当前调用这个方法的线程,直到 call 方法成功返回了,主线程才能够继续往下执行</u>)

当线程运行起来后,可以通过 FutureTask 的 get 方法阻塞获取任务运行结果:
```java
Integer result = task.get();
```
### 为什么使用 start 启动线程,而不使用 run 方法启动线程
`run()` 方法被称为**线程执行体**,它的方法体代表了线程需要完成的任务,而 `start()` 方法用来启动线程。 调用 `start()` 方法启动线程时,系统会把该 `run()` 方法当成线程执行体来处理。
但如果直接调用线程对象的 `run()` 方法,则 `run()` 方法立即就会被执行,而且在 `run()` 方法返回之前其他线程无法并发执行。**也就是说,如果直接调用线程对象的 `run()` 方法,系统把线程对象当成一个普通对象,而 `run()` 方法也是一个普 通方法,而不是线程执行体**。
> 举个例子:
>
> ```java
> // 创建线程
> Thread t1 = new Thread("t1") {
> @Override
> // run 方法内实现了要执行的任务
> public void run() {
> // 线程需要执行的任务
> System.out.println("开始执行");
> FileReader.read(文件地址); // 读文件
> }
> };
>
> t1.run();
> System.out.println("执行完毕");
> ```
>
> 如果使用 run 方法启动线程,"执行完毕" 这句话需要在文件读取完毕后才能够输出,也就是说读文件这个操作仍然是同步的。
>
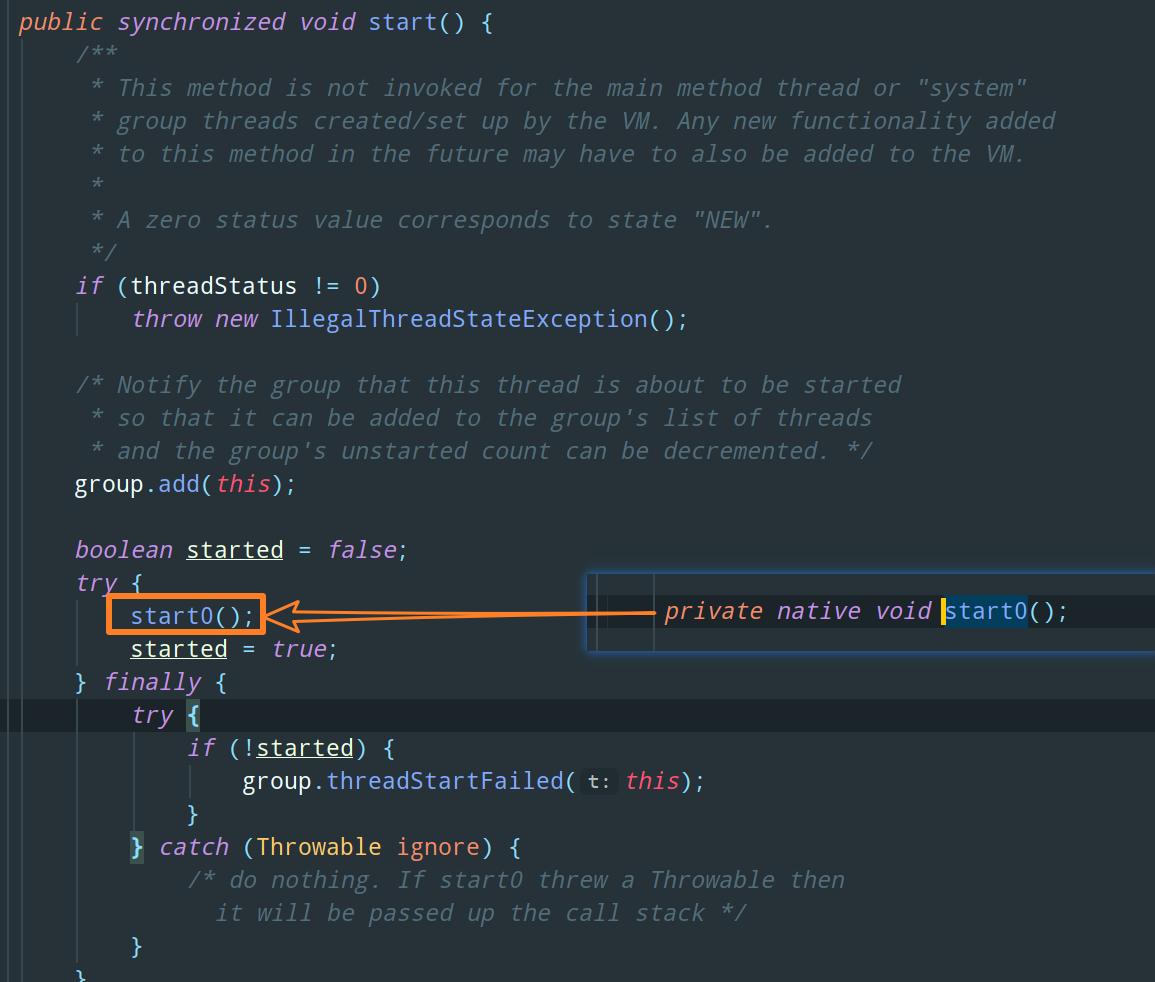
> 而 **`start` 方法会调用一个私有的 native 方法 `start0` 去创建新的线程**:
>
> 
>
> 使用 start 方法启动线程,"执行完毕" 这句话在文件读取完毕之前就会被很快地输出,因为多线程让方法执行变成了异步的,读取文件这个操作是 t1 线程在做,而 main 线程并没有被阻塞。
## 线程的状态 / 生命周期
线程的六种状态在以及各种状态之间的转换操作在 Thread 类中写得非常清楚:
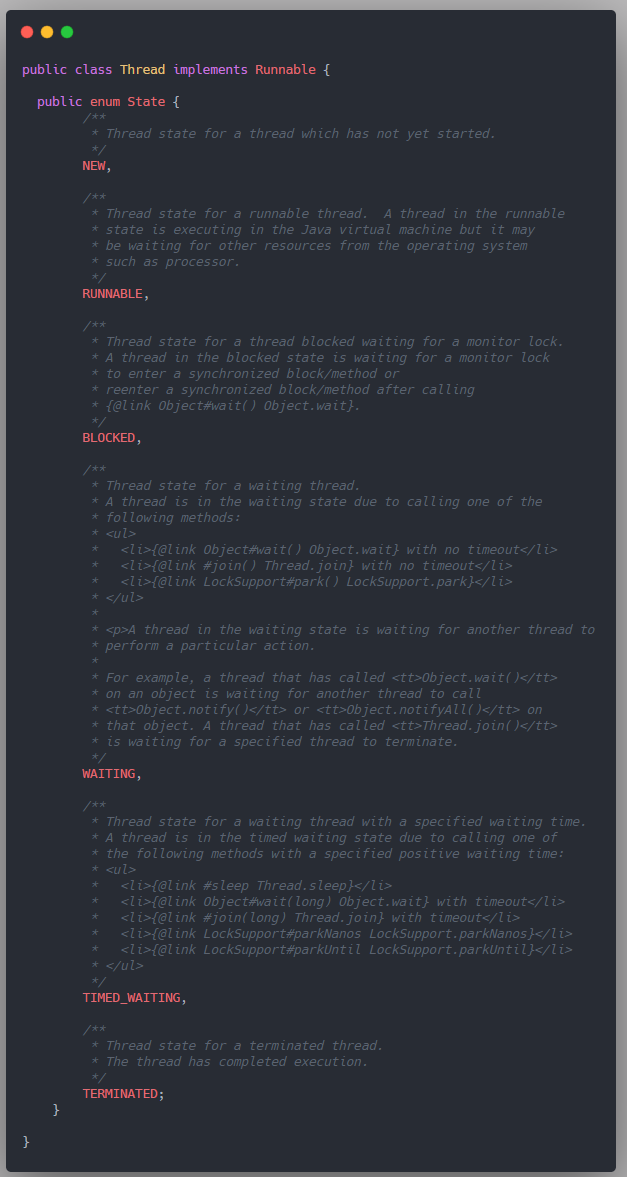
各状态的转换图如下:
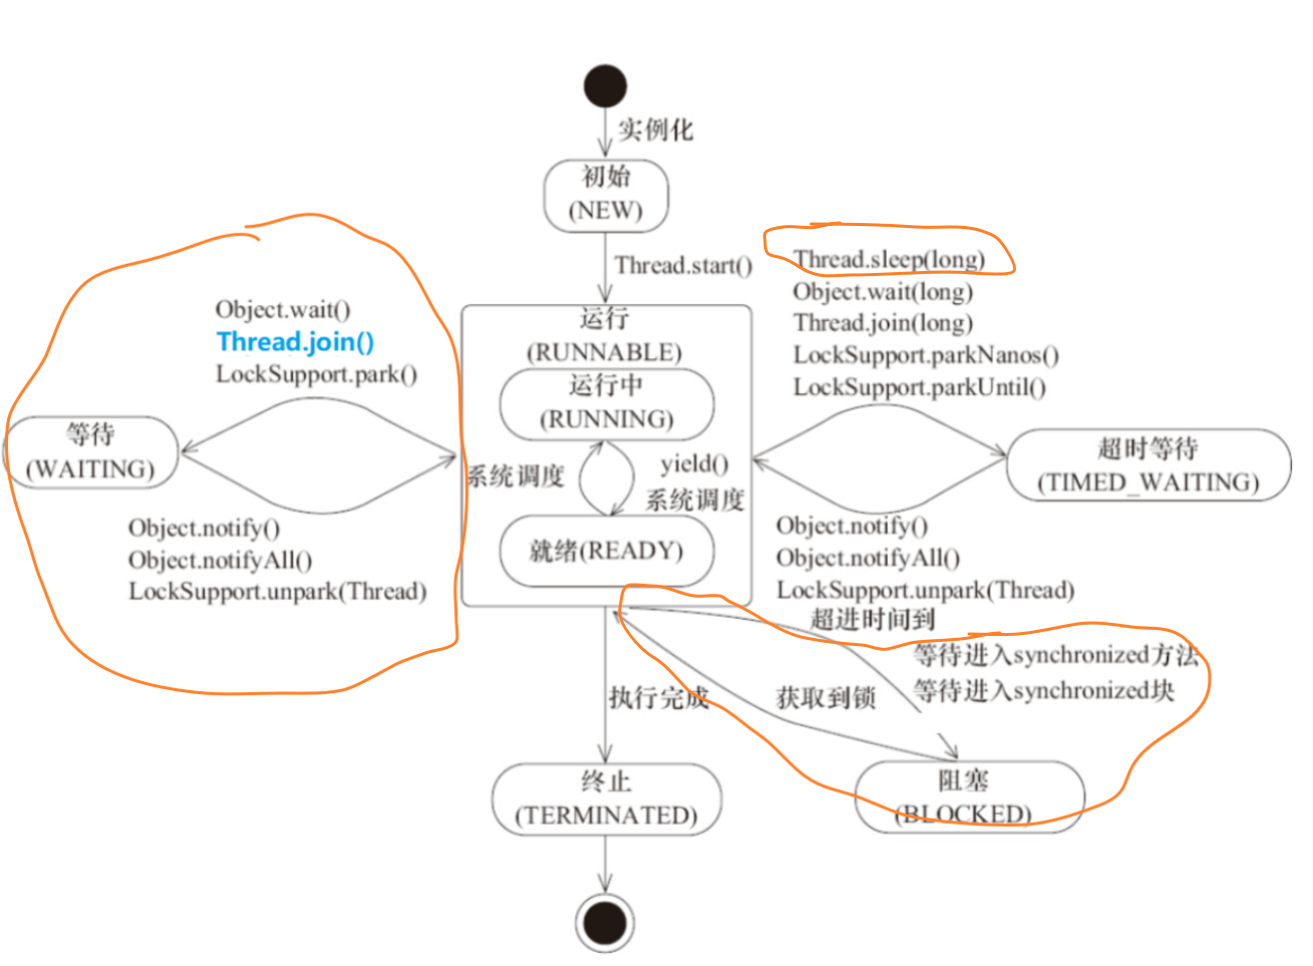
比较重要的其实就是图中我框出来的 3 个地方
下面详细分析:
1)`NEW`:初始状态,线程被创建出来但是还没有开始运行,也就是还没有调用 start 方法
2)`RUNNABLE`:当调用了 start 方法后,线程就进入了运行状态(RUNNABLE ),Java 线程将操作系统中线程的就绪(READY)和运行(RUNNING)两种状态统称为 “RUNNABLE”。
> 回顾下操作系统中经典的线程五态模型:
>
> 
3)`BLOCKED`:阻塞状态,表示线程阻塞于锁。
从 Thread 类的源码注释中我们可以看出,这个锁指的是 `monitor` 锁,即 `synchronized`。
就是说当线程试图获取 `synchronized` 锁住的对象的时候,**如果竞争锁失败了,那么这个线程就进入 BLOCKED 态**。
当持有该对象锁的线程的 `synchronized` 代码块执行完毕的时候,会唤醒该对象上所有 BLOCKED 的线程(BLOCKED 队列)重新竞争,如果其中 t 线程竞争成功,那么 t 线程就会从 BLOCKED 状态进入 RUNNABLE 状态 ,而其它竞争失败的线程仍然处于 BLOCKED 状态。
> 不同于 synchronized 锁的是,阻塞在 J.U.C 的 Lock 接口下的锁的线程状态并不是 BLOCKED 态,因为 Lock 接口对于阻塞的实现均使用了 LockSupport 类中的相关方法。从上面的转换图中可以看出,阻塞在 Lock 接口的线程状态是 WAITING 状态
4)`WAITNG`:等待状态,进入等待状态的线程需要依靠其他线程的通知才能够返回到 RUNNABLE 状态。
从 Thread 类的源码注释以及图片中可以看出来,线程从 RUNNABLE 到 WAITING 状态的转换有 3 种场景:
- 调用了 `Object.wait`
- 调用了 `Thread.join`
- 调用了 `LockSupport.park` 暂停线程
另外,线程从 WAITING 状态回到 RUNNABLE 的场景,从源码注释中同样也可以很清楚的看出来:
- 调用了 `Object.notify`
- 调用了 `Object.notifyAll`
- 调用了 `LockSupport.unpark` 恢复某个线程的运行
5)`TIMED_WAITING`:超时等待状态,该状态不同于 WAITING,它是可以在指定的时间自行返回到 RUNNABLE 状态。
这个没啥好说的,就是各种带上了 timeout 的等待函数,额外要注意的就是 sleep 函数
6)`TERMINATED`:终止状态,表示当前线程已经执行完毕。
<br>
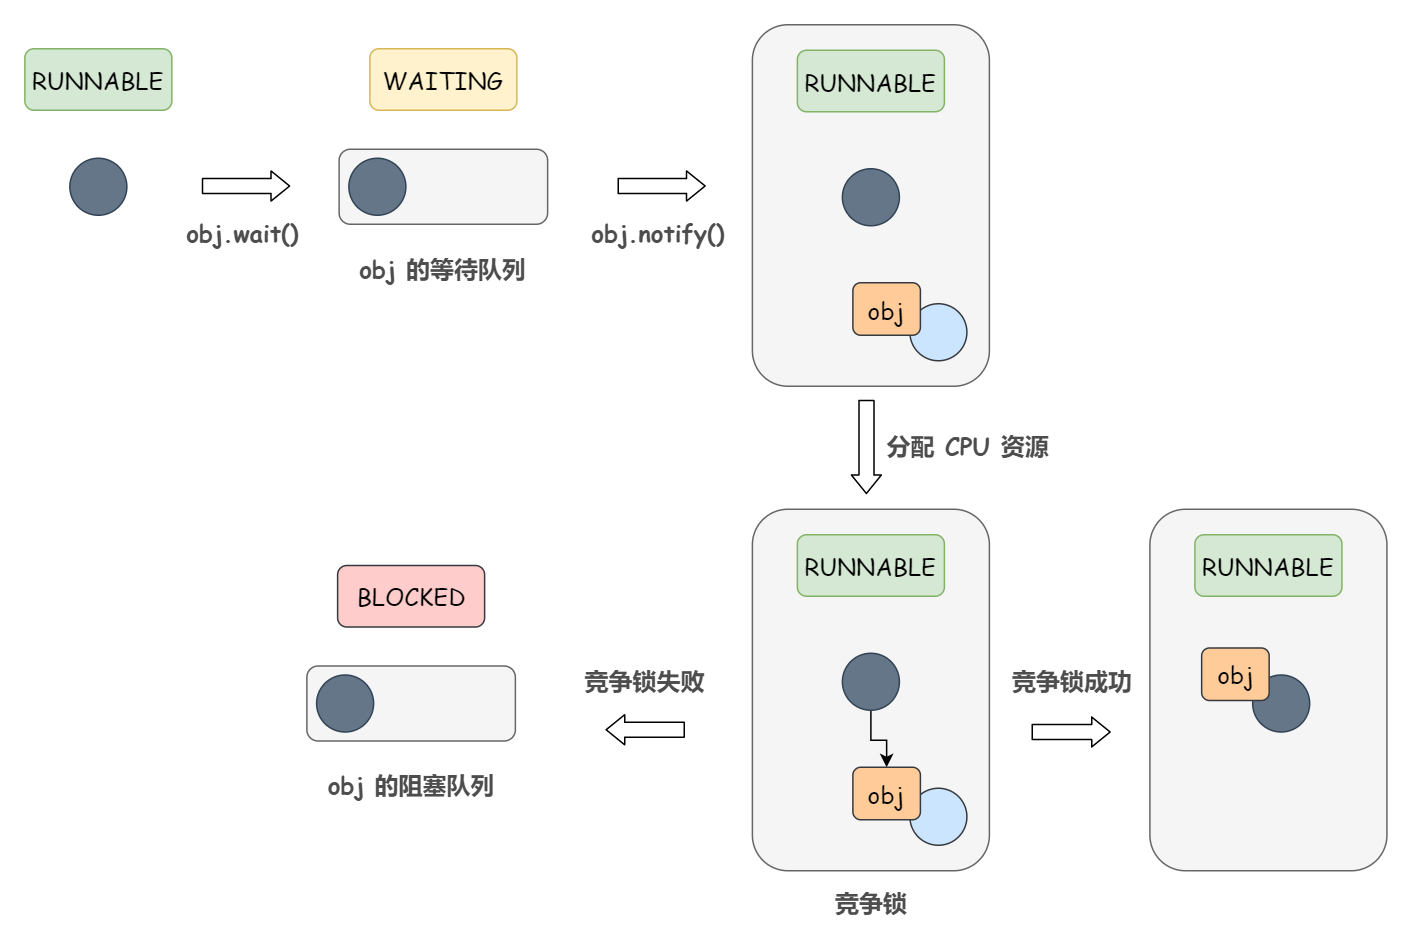
举一个线程状态转换的例子,帮助大家理解:
- 首先,线程调用了 `Object.wait`,线程状态变为 WAITING
- 当被另一个线程唤醒后,会先转换为 RUNNABLE 状态,等待操作系统分配 CPU 资源
- 分配到 CPU 资源后,该线程去竞争锁,如果竞争成功,才可以继续往下运行;如果竞争失败,就会从 RUNNABLE 状态变为 BLOCKED 状态
## Thread 类的常用方法
Thread 类主要提供了这么几个控制线程的函数
- start / run:上面已经说过了
- sleep / yield
- join / join(long n) + interrupt
- setDaemon 守护线程
- interrupt:中断线程,将该线程的中断标示位设置为 true(Thread对象的 native 实现里有一个成员代表线程的`中断状态`,我们可以认为它是一个 bool 型的变量。初始为 false),中断的结果线程是死亡、还是等待新的任务或是继续运行至下一步,就取决于这个程序本身。线程会不时地检测这个中断标示位,以判断线程是否应该被中断(中断标示值是否为true)。它并不像 stop 方法那样会中断一个正在运行的线程。
- interrupted:将中断标示位清除,即重新设置为 false
> 判断某个线程是否已被发送过中断请求,请使用 `Thread.currentThread().isInterrupted()` 方法,而不是 `Thread.interrupted()`(该方法调用后会将中断标示位清除,即重新设置为false),下面是线程在循环中时的中断方式:
>
> ```java
> while(!Thread.currentThread().isInterrupted() && more work to do){
> do more work
> }
> ```
### Thread.sleep 和 Object.wait 的区别
1)Object 提供的 `wait` 和 `notify`/`notifyAll` 函数是配合 `synchronized` 关键字(monitor 锁)来使用的;而 sleep 是 Thread 提供的静态方法。
两者都可以用来暂停线程的执行,wait 方法可以使得函数进入 WAITING 状态,wait(timeout) 和 sleep(timeout) 可以使函数进入 TIMED_WAITING 状态,sleep 方法必须指定 timeout。
wait,notify/notifyAll 只能在 synchronized 方法或者 synchronized 块里面使用,而 sleep 可以在任何地方使用
> sleep 是谁调用的谁去睡觉,即使在 a 线程里调用了 b 的 sleep 方法,实际上还是 a 去睡觉,要让 b 线程睡觉要在 b 的代码中调用 sleep
2)两者之间最大的区别在于:**sleep 不会释放持有的 monitor 锁,不会出让系统资源,而 `wait` 会释放掉 monitor 锁并出让系统资源**
3)一般用 sleep 暂停线程执行,而 wait 用于线程之间的通信
### sleep(0) 有什么用?
从字面上来看,sleep(0) 是让线程挂起 0 秒,看起来没啥用。
sleep(timeout) 的意思是,线程丢掉 CPU 时间片,挂起 timeout 秒,进入等待态(等待队列中的线程是不参与 CPU 调度的),timeout 秒之后,再转入就绪态,开始等候 CPU 调度。
**当一个线程调用 Thread.sleep(0) 方法时,它会立即放弃自己的 CPU 时间片,然后直接进入就绪态,继续参与 CPU 调度,使得其他等待线程有机会先执行,如果没有其他等待线程,则当前线程会继续执行。这种方式可以防止当前线程长时间占用 CPU 而导致其他线程无法执行的问题,从而提高系统的并发性能**。
下面是一个简单的示例代码,演示了如何使用 Thread.sleep(0) 方法让线程放弃 CPU 时间片:
```java
public class SleepZeroDemo {
public static void main(String[] args) {
Thread t1 = new Thread(() -> {
System.out.println("Thread 1 start");
Thread.sleep(0);
System.out.println("Thread 1 end");
});
Thread t2 = new Thread(() -> {
System.out.println("Thread 2 start");
System.out.println("Thread 2 end");
});
t1.start();
t2.start();
}
}
```
运行下你就会发现 Thread1 和 Thread2 是交替执行的。
### Thread.join 和 Object.wait 的区别
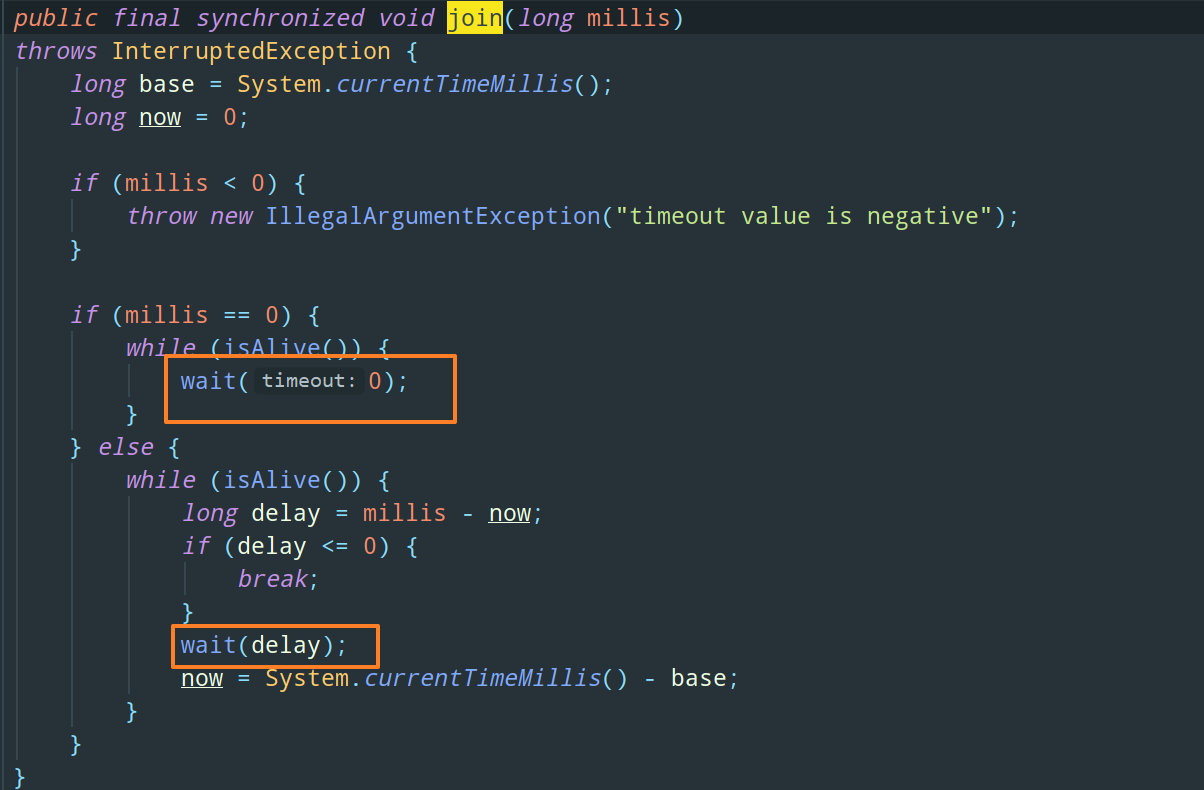
1)Object 提供的 `wait` 和 `notify`/`notifyAll` 函数是配合 `synchronized` 关键字(monitor 锁)来使用的;而 join 是 Thread 提供的方法。
> 不过 join 的底层其实也是通过 synchronized 和 wait 来实现的
>
> 
join 和 wait 都可以让线程进入 WAITING / TIMED_WAITING 状态。
**我们可以通过使用 notify()/notifyAll() 方法启动一个通过 wait() 方法进入等待状态的线程。但是我们不能打破 join() 方法所施加的等待,除非中断(`Thread.interrupt` 方法)或者调用了 join 的线程执行完毕**
2)具体使用逻辑上也是有所区别的
比如说 t 线程用 synchronized 获取了对象锁后,然后调用了 `wait()` 方法,**t 线程**就会从 RUNNABLE 状态变成 WAITING 状态。注意,这里是 t 线程。
如果当前线程也就是 main 线程调用 `t.join()` 方法时,**当前线程**从 RUNNABLE 态变成 WAITING 态(注意这里是当前线程),**当前线程必须等待 t 线程执行完毕后,才可以继续执行下去**。
### sleep 和 yield 的区别
**yield() 方法和 sleep() 方法类似,都不会释放锁**,区别在于:
1)sleep 方法需要 timeout 参数,而 yield 方法不需要参数
2)sleep 方法给其他线程运行机会时不考虑其他线程的优先级,因此会给低优先级的线程运行的机会;yield() 方法只会给相同优先级或更高优先级的线程运行的机会
3)线程执行 sleep 方法后转入超时等待状态(TIMED_WAITING),而执行 yield 方法后转入就绪状态(Java 线程将操作系统中线程的就绪(READY)和运行(RUNNING)两种状态统称为 “RUNNABLE”)

4)sleep 方法声明抛出 InterruptedException 异常,而 yield 方法没有声明任何异常
### setDaemon 守护线程
#### 什么是守护线程
Java 把线程分成两类:用户线程(User Thread) + 守护线程(Daemon Thread)
守护线程的使用有以下要点:
- 当程序中所有的用户线程执行完毕之后,不管守护线程是否结束,系统都会自动退出(也就是说只要存在一个用户线程在允许,守护线程就不会结束)
- 守护线程必须在 `start` 启动前通过 `setDaemon()` 方法将状态设置为 true,启动后就不能进行设置,否则报 InterruptedException 异常
- 守护线程存在被 JVM 强制终止的风险,所以在守护线程中尽量不去访问系统资源,例如打开文件等,因为虚拟机退出时,守护线程没有任何机会来关闭文件,这会导致数据丢失
- 守护线程中创建的线程也是守护线程
JVM 进程中的 GC 线程就是一个守护线程,这样设计目的很明确,当你所有的程序都执行完毕了,留着这个 GC 线程就没有任何意义了。反过来可以设想,如果把 GC 线程设计成非守护线程,当你明确你的程序都执行完毕了,但是就是不自动退出岂不是很奇怪?
#### 守护线程的底层原理
以下参考链接:https://juejin.cn/post/6844903966539513870
守护线程底层原理是啥?是怎么区分与用户线程的?为什么用户线程结束守护线程就能自动退出?(我当时面中国移动的原题,属实有点懵了)
我们看到 JVM 源码 `thread.cpp` 文件,这里是实现线程的代码。可以肯定有一段代码监测着当前非守护线程的数量,不然怎么知道现在只剩下守护线程呢?很有可能是在移除线程的方法里面,跟着这个思路,我们看看该文件的 `remove()` 方法。代码如下
```c++
/**
* 移除线程 p
*/
void Threads::remove(JavaThread* p, bool is_daemon) {
// Reclaim the ObjectMonitors from the omInUseList and omFreeList of the moribund thread.
ObjectSynchronizer::omFlush(p);
/**
* 创建一个监控锁对象 ml
*/
// Extra scope needed for Thread_lock, so we can check
// that we do not remove thread without safepoint code notice
{
MonitorLocker ml(Threads_lock);
assert(ThreadsSMRSupport::get_java_thread_list()->includes(p), "p must be present");
// Maintain fast thread list
ThreadsSMRSupport::remove_thread(p);
// 当前线程数减 1
_number_of_threads--;
if (!is_daemon) {
/**
* 非守护线程数量减 1
*/
_number_of_non_daemon_threads--;
/**
* 当非守护线程数量为 1 时,唤醒在 destroy_vm() 方法等待的线程
*/
// Only one thread left, do a notify on the Threads_lock so a thread waiting
// on destroy_vm will wake up.
if (number_of_non_daemon_threads() == 1) {
ml.notify_all();
}
}
/**
* 移除掉线程
*/
ThreadService::remove_thread(p, is_daemon);
// Make sure that safepoint code disregard this thread. This is needed since
// the thread might mess around with locks after this point. This can cause it
// to do callbacks into the safepoint code. However, the safepoint code is not aware
// of this thread since it is removed from the queue.
p->set_terminated_value();
} // unlock Threads_lock
// Since Events::log uses a lock, we grab it outside the Threads_lock
Events::log(p, "Thread exited: " INTPTR_FORMAT, p2i(p));
}
```
我在里面加了一些注释,可以发现,果然是我们想的那样,里面有 `_number_of_non_daemon_threads` 记录着非守护线程的数量,而且当非守护线程数为 1 时,就会唤醒在 `destory_vm()` 方法里面等待的线程,紧接着我们看看 `destory_vm()` 代码,同样是在 `thread.cpp` 文件下:
```c++
bool Threads::destroy_vm() {
JavaThread* thread = JavaThread::current();
#ifdef ASSERT
_vm_complete = false;
#endif
/**
* 等待自己是最后一个非守护线程条件
*/
// Wait until we are the last non-daemon thread to execute
{ MonitorLocker nu(Threads_lock);
while (Threads::number_of_non_daemon_threads() > 1)
/**
* 非守护线程数大于 1,则一直等待
*/
// This wait should make safepoint checks, wait without a timeout,
// and wait as a suspend-equivalent condition.
nu.wait(0, Mutex::_as_suspend_equivalent_flag);
}
/**
* 下面代码是关闭 VM 的逻辑
*/
EventShutdown e;
if (e.should_commit()) {
e.set_reason("No remaining non-daemon Java threads");
e.commit();
}
// ...... 省略余下代码
}
```
我们这里看到**当非守护线程数量大于 1 时,就一直等待,直到剩下一个非守护线程时,就会在线程执行完后,退出 JVM**。这时候又有一个点需要定位,什么时候调用 `destroy_vm()` 方法呢?还是通过查看代码以及注释,发现是在 `main()` 方法执行完成后触发的。
在 `java.c` 文件的 `JavaMain()` 方法里面,最后执行完调用了 `LEAVE()` 方法,该方法调用了 `(*vm)->DestroyJavaVM(vm); ` 来触发 JVM 退出,最终调用 `destroy_vm()` 方法。
```c++
#define LEAVE() \
do { \
if ((*vm)->DetachCurrentThread(vm) != JNI_OK) { \
JLI_ReportErrorMessage(JVM_ERROR2); \
ret = 1; \
} \
if (JNI_TRUE) { \
(*vm)->DestroyJavaVM(vm); \
return ret; \
} \
} while (JNI_FALSE)
```
所以我们也知道了,**为啥 main 线程可以比子线程先退出**?虽然 main 线程退出前调用了 `destroy_vm()` 方法,但是在 `destroy_vm()` 方法里面等待着非守护线程执行完,子线程如果是非守护线程,则 JVM 会一直等待,不会立即退出。
我们对这个点总结一下:**Java 程序在 main 线程执行退出时,会触发执行 JVM 退出操作,但是 JVM 退出方法** **`destroy_vm()`** **会等待所有非守护线程(用户线程)都执行完:使用变量 `_number_of_non_daemon_threads` 统计非守护线程的数量,这个变量在新增线程和删除线程时会做增减操作**。
另外衍生一点就是:**当 JVM 退出时,所有还存在的守护线程会被抛弃,既不会执行 finally 部分代码,也不会执行 stack unwound 操作(也就是也不会 catch 异常)**。这个很明显,JVM 都退出了,守护线程自然退出了,当然这是守护线程的一个特性。