


内核态和用户态
@[toc]
---
## 什么是内核态和用户态
**所谓内核,其实就是操作系统中的一组程序**,作为可信软件来提供支持进程并发执行的基本功能和基本操作,**具有访问硬件设备和所有内存空间的权限**,内核是操作系统的核心。
当然,操作系统除了内核程序外,还有包括其他一些基本组件,如文本编辑器、编译器、用来与用户进行交互的程序比如桌面系统等。
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20210216232533.png" style="zoom: 67%;" />
那么既然内核是程序,它需要运行,就必须被分配 CPU。因此,CPU 上会运行两种程序,一种是操作系统的内核程序(也称为系统程序),一种是应用程序。**前者完成系统任务,后者实现应用任务。两者之间有控制和被控制的关系,前者有权管理和分配资源,而后者只能向系统申请使用资源**。
我们把在 CPU 上运行的这两类程序加以区分,这就是内核态和用户态出现的原因。
- **内核态**(kernel mode):当 CPU 处于内核态时,这是操作系统管理程序(也就是内核)运行时所处的状态。运行在内核态的程序可以访问计算机的任何资源,不受限制,为所欲为,例如协调 CPU 资源,分配内存资源,提供稳定的环境供应用程序运行等。
- **用户态**(user mode):应用程序基本都是运行在用户态的,或者说用户态就是提供应用程序运行的空间。运行在用户态的程序只能访问当前 CPU 上执行程序所在的地址空间,这样有效地防止了操作系统程序受到应用程序的侵害。
对操作系统来说,**什么样的程序应该放在内核态呢**?这取决于对资源的需求、时间的紧迫和效率高低等因素。比如 CPU、内存、设备等资源管理器程序应该在内核态运行,否则安全性没有保证。对于文件系统和数据来说,文件系统数据和管理必须放在内核态,但是用户的数据和管理可以放在用户态。
## 中断 Interruption
### 什么是中断
**操作系统是由中断驱动的**
在合适的情况下,操作系统的内核会把 CPU 的使用权主动让给应用程序,也就是使 CPU 从内核态转换到用户态。而 **CPU 要想从用户态回到内核态,只能通过中断机制完成**
这里的中断机制非常广义,包含了三种手段,也就是说从用户态转换到内核态有三种手段:
- 程序请求操作系统服务,执行**系统调用**(系统调用其实属于内中断)
- 程序运行时产生**外中断**事件(比如 I/O 操作完成),运行程序被中断,转向中断程序处理
- 在程序运行时发生**内中断**(异常)事件,运行程序被打断,转向异常处理程序工作
按照中断信号来源于 CPU 的外部还是内部,将中断类型分为外中断和内中断:
- **外中断** (也称中断,狭义上的中断)
外中断与当前执行的指令无关, 中断信号来源于 CPU 外部。如 I/O 完成中断,表示设备输入/输出处理已经完成,CPU 能够发送下一个输入/输出请求。此外还有时钟中断、控制台中断等。
- **内中断**(也称 **异常 Exception**、例外)
指 CPU 内部出现的中断,即在 CPU 执行特定指令时出现的非法情况,因此只有在一条指令执行后才会发出内中断,不可能在指令执行期间发生内中断。常见的内中断如非法操作码、地址越界、算术溢出,除数为 0 等。
### 中断机制的基本原理
不同的中断信号,肯定是需要用不同的中断处理程序来处理的。那么当 CPU 检测到中断信号后,就会根据中断信号的类型去查询**中断向量表**,中断向量表是操作系统中一个重要的数据结构,它存储了每个中断类型对应的中断处理程序的入口地址。当发生中断时,CPU会根据中断类型从中断向量表中查找对应的中断处理程序入口地址,然后跳转到该地址执行中断处理程序。
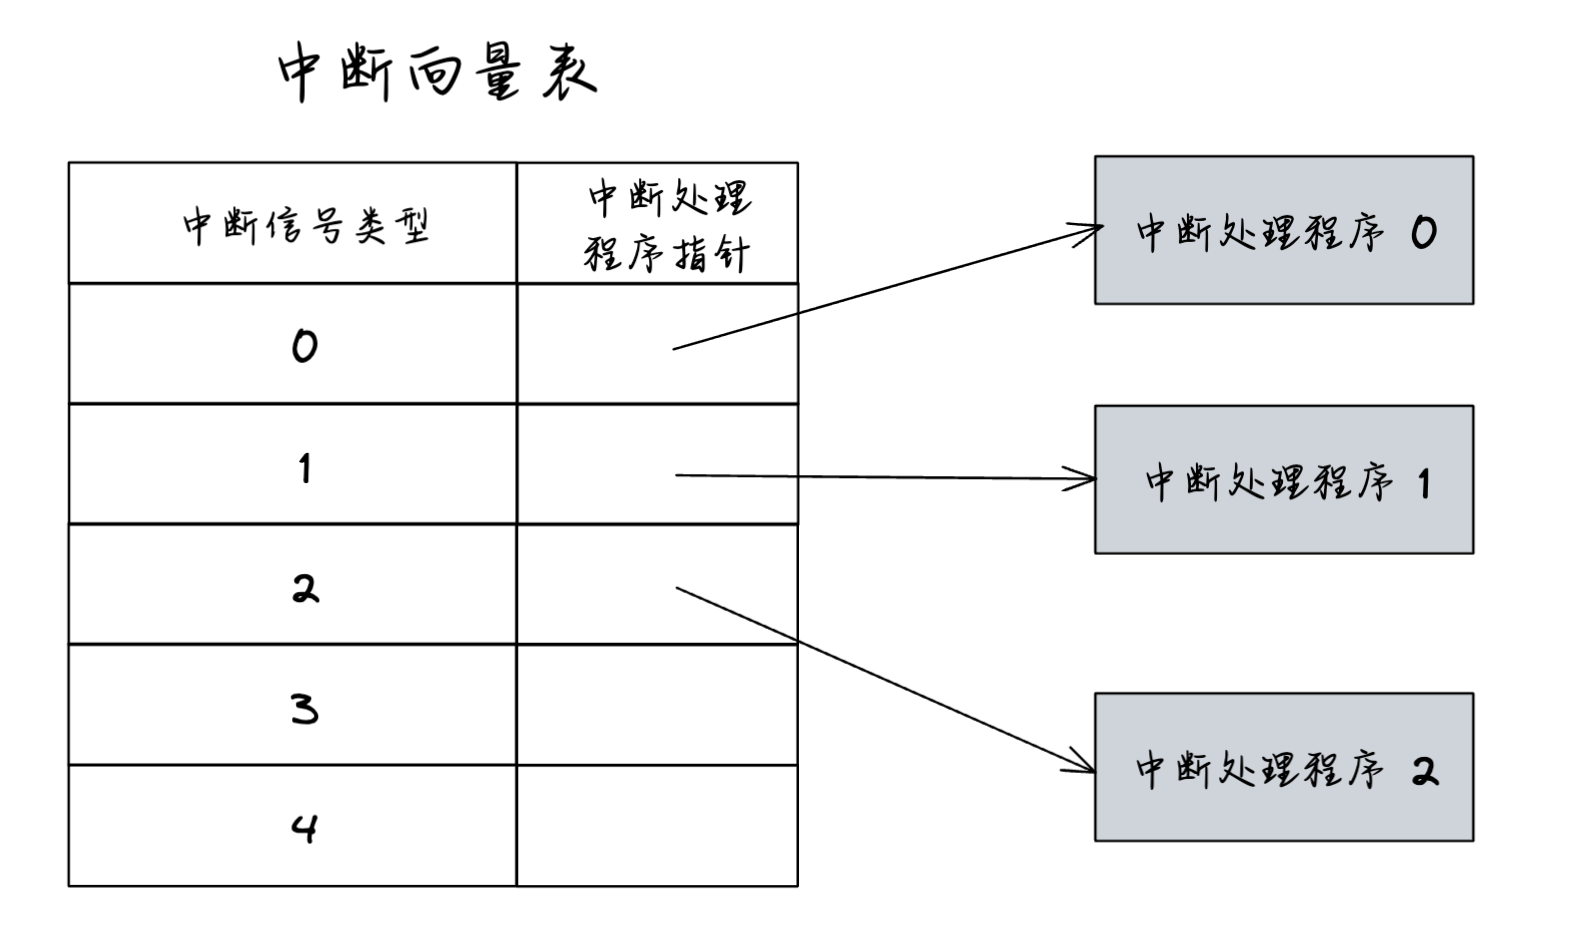
中断机制的主要流程如下:
1. 当硬件设备需要处理数据或产生异常情况时,会向CPU发送中断信号。
2. CPU在接收到中断信号后,暂停当前任务,将当前任务的上下文环境保存到内存中,以便后续恢复现场。
3. CPU 根据中断向量表找到中断处理程序,执行相应的操作,如保存现场、执行中断服务例程、恢复现场等。
4. 中断处理程序完成中断服务例程后,将控制权交还给原程序,使其继续执行。
5. 原程序从上次中断的位置继续执行,并恢复之前保存的上下文环境。
### 系统调用 System call
**系统调用也属于中断机制的一种**
因为系统调用是通过**陷入指令**完成的,该指令会引发**内中断**
系统调用具体是什么?
操作系统作为计算机硬件之上的第一层软件,需要向上层提供一些简单易用的服务,这个上层包括用户和应用程序:

给用户提供的接口有图形界面 GUI 和命令接口,给应用程序提供的是程序接口,这个程序接口就是由一组系统调用组成的,是操作系统提供给开发人员使用的。所以系统调用其实就是**可供应用程序调用的特殊函数**,**应用程序可以通过系统调用来请求获得操作系统内核的服务**。
<br>
**系统调用的过程**大致如下:
1)在用户态,应用程序传递系统调用参数
2)执行陷入指令 `trap`,引发一个内中断,使 CPU 进入内核态
3)在内核态,执行相应的请求,内核程序处理系统调用
4)返回应用程序
### 为什么系统调用是必须的?
举个例子:我们去学校打印店打印论文,你按下了 WPS 的 “打印” 选项,于是打印机开始工作。 你的论文打印到一半时,另一位同学按下了 Word 的 “打印” 按钮,开始打印他自己的论文。想象一下如果两个进程可以随意的、并发的共享打印机资源,会发生什么情况?
显然,两个进程并发运行,导致打印机设备交替的收到 WPS 和 Word 两个进程发来的打印请求,结果两篇论文的内容混杂在一起了
如何解决这个问题?这就需要操作系统内核对共享资源进行统一的管理,并向上层提供 “系统调用” ,运行在用户态的应用程序或者进程想要使用打印机这种共享资源,只能通过系统调用向操作系统内核发出请求,然后内核会对各个请求进行协调处理(进程调度)。
通过上面这个例子,我们就可以总结出什么功能会用到系统调用:**凡是与共享资源有关的操作(比如内存分配、I/O 操作、文件管理等),都必须通过系统调用的方式向操作系统内核提出请求,由操作系统内核代为完成**。这样可以保证系统的稳定性和安全性,防止用户进行非法操作。这些系统调用按功能大致可分为如下几类:
- 设备管理。完成设备的请求或释放,以及设备启动等功能。
- 文件管理。完成文件的读、写、创建及删除等功能。
> 最常见的就是 read 和 write 这俩
>
> - read:从文件中读取内容
> - write:往文件中写入内容
- 进程控制。完成进程的创建、撤销、阻塞及唤醒等功能。
- 进程通信。完成进程之间的消息传递或信号传递等功能。
- 内存管理。完成内存的分配、回收以及获取作业占用内存区大小及地址等功能。
## 内核缓冲区和用户缓冲区
根据内核态和用户态的定义,我们不难理解内核空间和用户空间的定义
- 用户操作系统内核能够访问的**内存**区域呢,就称为**内核空间**,它独立于普通的应用程序,是受保护的内存空间
- 而普通应用程序可访问的内存区域呢,就是**用户空间**
当我们说一个应用程序从磁盘上读取文件时,通常分两步走:

**操作系统(内核)先从磁盘上读取数据存到内核空间,再把数据从内核空间拷贝到用户空间。此后,用户应用程序才可以操作此数据**。
所以,在这个过程中有两次数据读取操作:
1. 第一步:从磁盘上读取
2. 第二步:从内存中读取
### 内核缓冲区
众所周知,访问磁盘的速度要远远低于访问内存的速度,完全不是一个量级的,所以理论上 read 磁盘的速度要远远慢于 read 内存。
那么整个文件读取过程的最大时间瓶颈就出现在了对磁盘的读取上。
要解决这个问题,**内核缓冲区**(`Kernel Buffer Cache`)就应运而生了。
**本质上其实就是内核空间的一块内存区域罢了**
从 Buffer Cache(缓冲区缓存)这个名字上能看出来,内核缓冲区(准确的说,应该是**内核缓冲区缓存**),其实有两个作用,缓冲(Buffer) + 缓存(Cache)
1)先来看看它是怎么充当 **Cache** 的:
- **数据预读(read-ahead)**:数据预读指的是,<u>当程序发起 read() 系统调用时,内核会比请求更多地读取磁盘上的数据,保存在缓冲区,以备程序后续使用。这种数据的预取策略其实就是基于局部性原理</u>
因此当我们向内核请求读取数据时,内核会先到内核缓冲区中去寻找,如果命中数据,则不需要进行真正的磁盘 I/O,直接从缓冲区中返回数据就行了;如果缓存未命中,则内核会从磁盘中读取请求的 page,并同时读取紧随其后的几个 page(比如三个),如果文件是顺序访问的,那么下一个读取请求就会命中之前预读的缓存(当然了,预读算法非常复杂,这里只是一个简化的逻辑)。
2)再来看看内核缓冲区是怎么充当 **Buffer** 的:
- **延时回写(write-behind)**:回写指的是,<u>当程序发起 write() 系统调用时,内核并不会直接把数据写入到磁盘文件中,而仅仅是写入到缓冲区中,几秒后(或者说等数据堆积了一些后)才会真正将数据刷新到磁盘中</u>。对于系统调用来说,数据写入缓冲区后,就返回了。
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20220420160031.png" alt="有无 Buffer 的对比图" style="zoom:50%;" />
延迟往磁盘写入数据的最大一个好处就是,可以合并更多的数据一次性写入磁盘,把小块的 I/O 变成大块 I/O,减少磁盘处理命令次数,从而提高提盘性能。
另一个好处是,当其它进程紧接着访问该文件时,内核可以从直接从缓冲区中提供更新的文件数据(这里又是充当 Cache 了)。
### 用户缓冲区
上面提到,read 磁盘的速度要远远慢于 read 内存,不过事实上,**read 内存这个操作也挺费时的,因为应用程序想要访问系统资源的话,就要通过系统调用 or 中断(外中断、内中断)使得 CPU 从用户态转向内核态,这个状态的改变需要涉及堆栈的环境和数据变化,还是挺需要时间的**。
那为了**减少系统调用的发生**呢(或者说,减少用户态和内核态的转换次数),就设计了用户缓冲区。
作用和内核缓冲区一样,数据预读 + 延时回写,既充当 Cache 又充当 Buffer。
不同的就是,**内核缓冲区处理的是内核空间和磁盘之间的数据传递,目的是减少访问磁盘的次数;而用户缓冲区处理的是用户空间和内核空间的数据传递,目的是减少系统调用的次数**(感觉这句话总结的不错,给自己点个赞)

> 另外,从上面的分析我们可以看出,read() 和 write() 都并非真正执行 I/O 操作(或者说,都并不直接和磁盘进行交互),它只代表数据在用户空间 / 内核空间传递的完成,<u>read 是把数据从内核缓冲区复制到用户缓冲区,write 是把用户缓冲区复制到内核缓冲区(而内核缓冲区的数据其实是通过操作系统层面的 I/O 接口从磁盘读取或写入)</u>
### 内核缓冲区和 Socket 缓冲区的区别
Socket 缓冲区(发送缓冲区和接收缓冲区)也就是 TCP 发送窗口和接收窗口,无论是 Socket 缓冲区,还是内核缓冲区,首先当然都是在内核的(所以如果不抠定义的话,Socket 缓冲区其实也是一种内核缓冲区)
接收网络数据:
- 整个数据的流程中,首先网卡接收到的数据存放到内核缓冲区内
- 然后内核缓冲区存放的数据根据 TCP 信息将数据移动到具体的某一个 TCP 连接上的接收缓冲区内,也就是接收滑动窗口内
- 然后用户进程从 TCP 的接受缓冲区内读取数据,如果应用程序一直不读取,那么滑动窗口就会变小,直至为 0
发送网络数据:
- 用户程序将数据拷贝到各自 TCP 发送缓冲区内(也就是发送滑动窗口)
- 然后内核将所有 Socket 的发送缓冲区(也就是发送滑动窗口)内的数据都拷贝到内核发送缓冲区内,然后内核将内核缓冲区的数据经过网卡发送出去。
总结来说,Socket 的发送/接受缓冲区(也就是发送/接受滑动窗口),是针对某一个具体的 TCP 连接来说的,每一个 TCP连接都会有相应的滑动窗口,但是内核的发送/接受缓冲区是针对整个系统的,里面存放着整个系统的所有 TCP 连接的接收/发送的数据