


压缩列表 ziplist
@[toc]
---
## 为什么称之为压缩列表?
1)相对数组来说节省内存
- 数组要求每个元素大小相同
- 压缩列表中每个元素可以占用不同大小的空间
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/image-20230505151001275.png" style="zoom: 50%;" />
2)给每个节点添加了 `previous_entry_length` 的属性,用来表示前一个节点的长度,方便查找
## 压缩列表的定义
一个压缩列表可以包含任意多个节点(entry),每个节点可以保存一个字节数组或者一个整数值
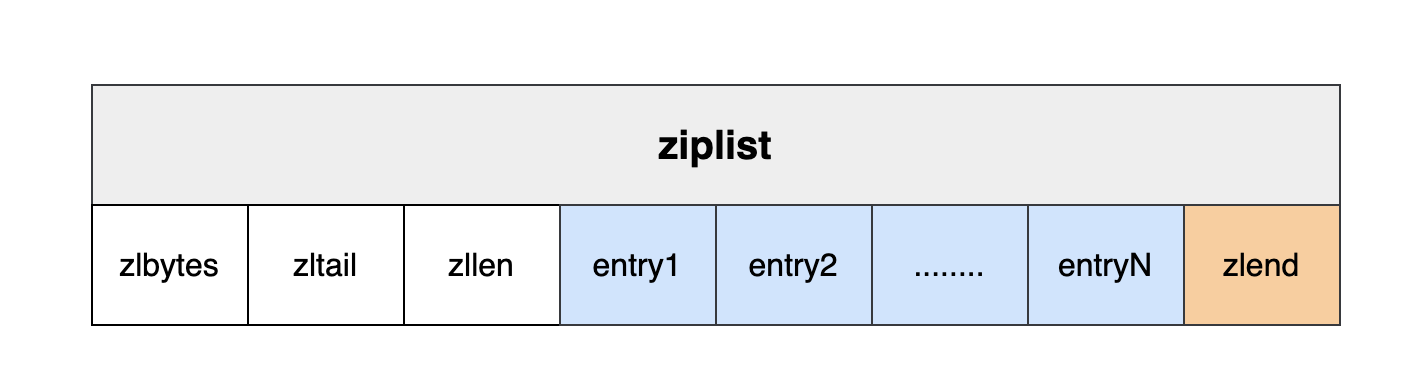
`zlbytes`:记录整个压缩列表占用的内存字节数
`zltail`:记录压缩列表表尾节点距离压缩列表的起始地址有多少字节。通过这个偏移量,程序无须遍历整个压缩列表就可以确定表尾节点的地址
`zllen`:记录了压缩列表包含的节点数量
`entry`:压缩列表包含的各个节点,节点的长度由节点保存的内容决定
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20220608174029.png" style="zoom: 67%;" />
每个压缩列表节点都由 `previous_entry_length`、`encoding`、`content` 三个部分组成
- previous_entry_length:**以字节为单位,记录了压缩列表中前一个节点的长度。previous_entry_length 属性的长度可以是 1 字节或者 5 字节**
- 1 字节:如果前一节点的长度 `< 254` 字节,那么 previous_entry_length 属性的长度为 1 字节,前一节点的长度就保存在这一个字节里面
- 5 字节:如果前一节点的长度 `>= 254` 字节,那么 previous_entry_length 属性的长度为 5 字节:其中属性的第一字节会被设置为 `0xFE`(十进制值254),而之后的四个字节则用于保存前一节点的长度
- encoding:记录了节点的 content 属性所保存数据的类型以及长度
- content:负责保存节点的值,节点值可以是一个字节数组或者整数,值的类型和长度由节点的 encoding 属性决定
`zlend`:特殊值 0xFF(十进制255),用于标记压缩列表的末端
## 连锁更新 cascade update
### 什么是连锁更新?
当 ziplist **添加** or **删除**一个节点的的时候,其他节点的 previous_entry_length 属性就需要进行更新,结合该属性的两种情况(1 字节 or 5 字节),程序可能需要对压缩列表执行连续多次的空间扩展操作
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20220608174653.png" style="zoom:55%;" />
### 连锁更新会影响压缩列表的性能吗?
不会。
尽管连锁更新的复杂度较高,但它真正造成性能问题的几率是很低的
- 首先,压缩列表里要恰好有多个连续的、长度介于 250 字节至 253 字节之间的节点,连锁更新才有可能被引发,在实际中,这种情况并不多见
- 其次,即使出现连锁更新,但只要被更新的节点数量不多,就不会对性能造成任何影响
因为此,ziplist 插入和删除节点命令的平均复杂度仅为 O(N),在实际中,我们可以放心地使用这些函数,而不必担心连锁更新会影响压缩列表的性能
> 另外,Redis 针对压缩列表在设计上的不足,在后来的版本中,新增设计了两种数据结构,这两种数据结构的设计目标,就是尽可能地保持压缩列表节省内存的优势,同时解决压缩列表的「连锁更新」的问题
>
> - quicklist(Redis 3.2 引入)
> - listpack(Redis 5.0 引入)
## quicklist(Redis 3.2 引入)
Redis 3.2 之前,List 对象的底层实现是 ziplist(压缩列表) + list(链表),Redis 3.2 将其更换为 `quicklist` 这个数据结构
所以 quicklist 其实就是弥补 ziplist 和 list 各自的不足:
- ziplist(压缩列表)的不足:如果 ziplist 太长,那么发生连锁更新就可能带来更大的负担
- list(双端链表)的不足:空间占用较多
如何既保留 ziplist 的空间高效性,又能不让其更新复杂度过高?
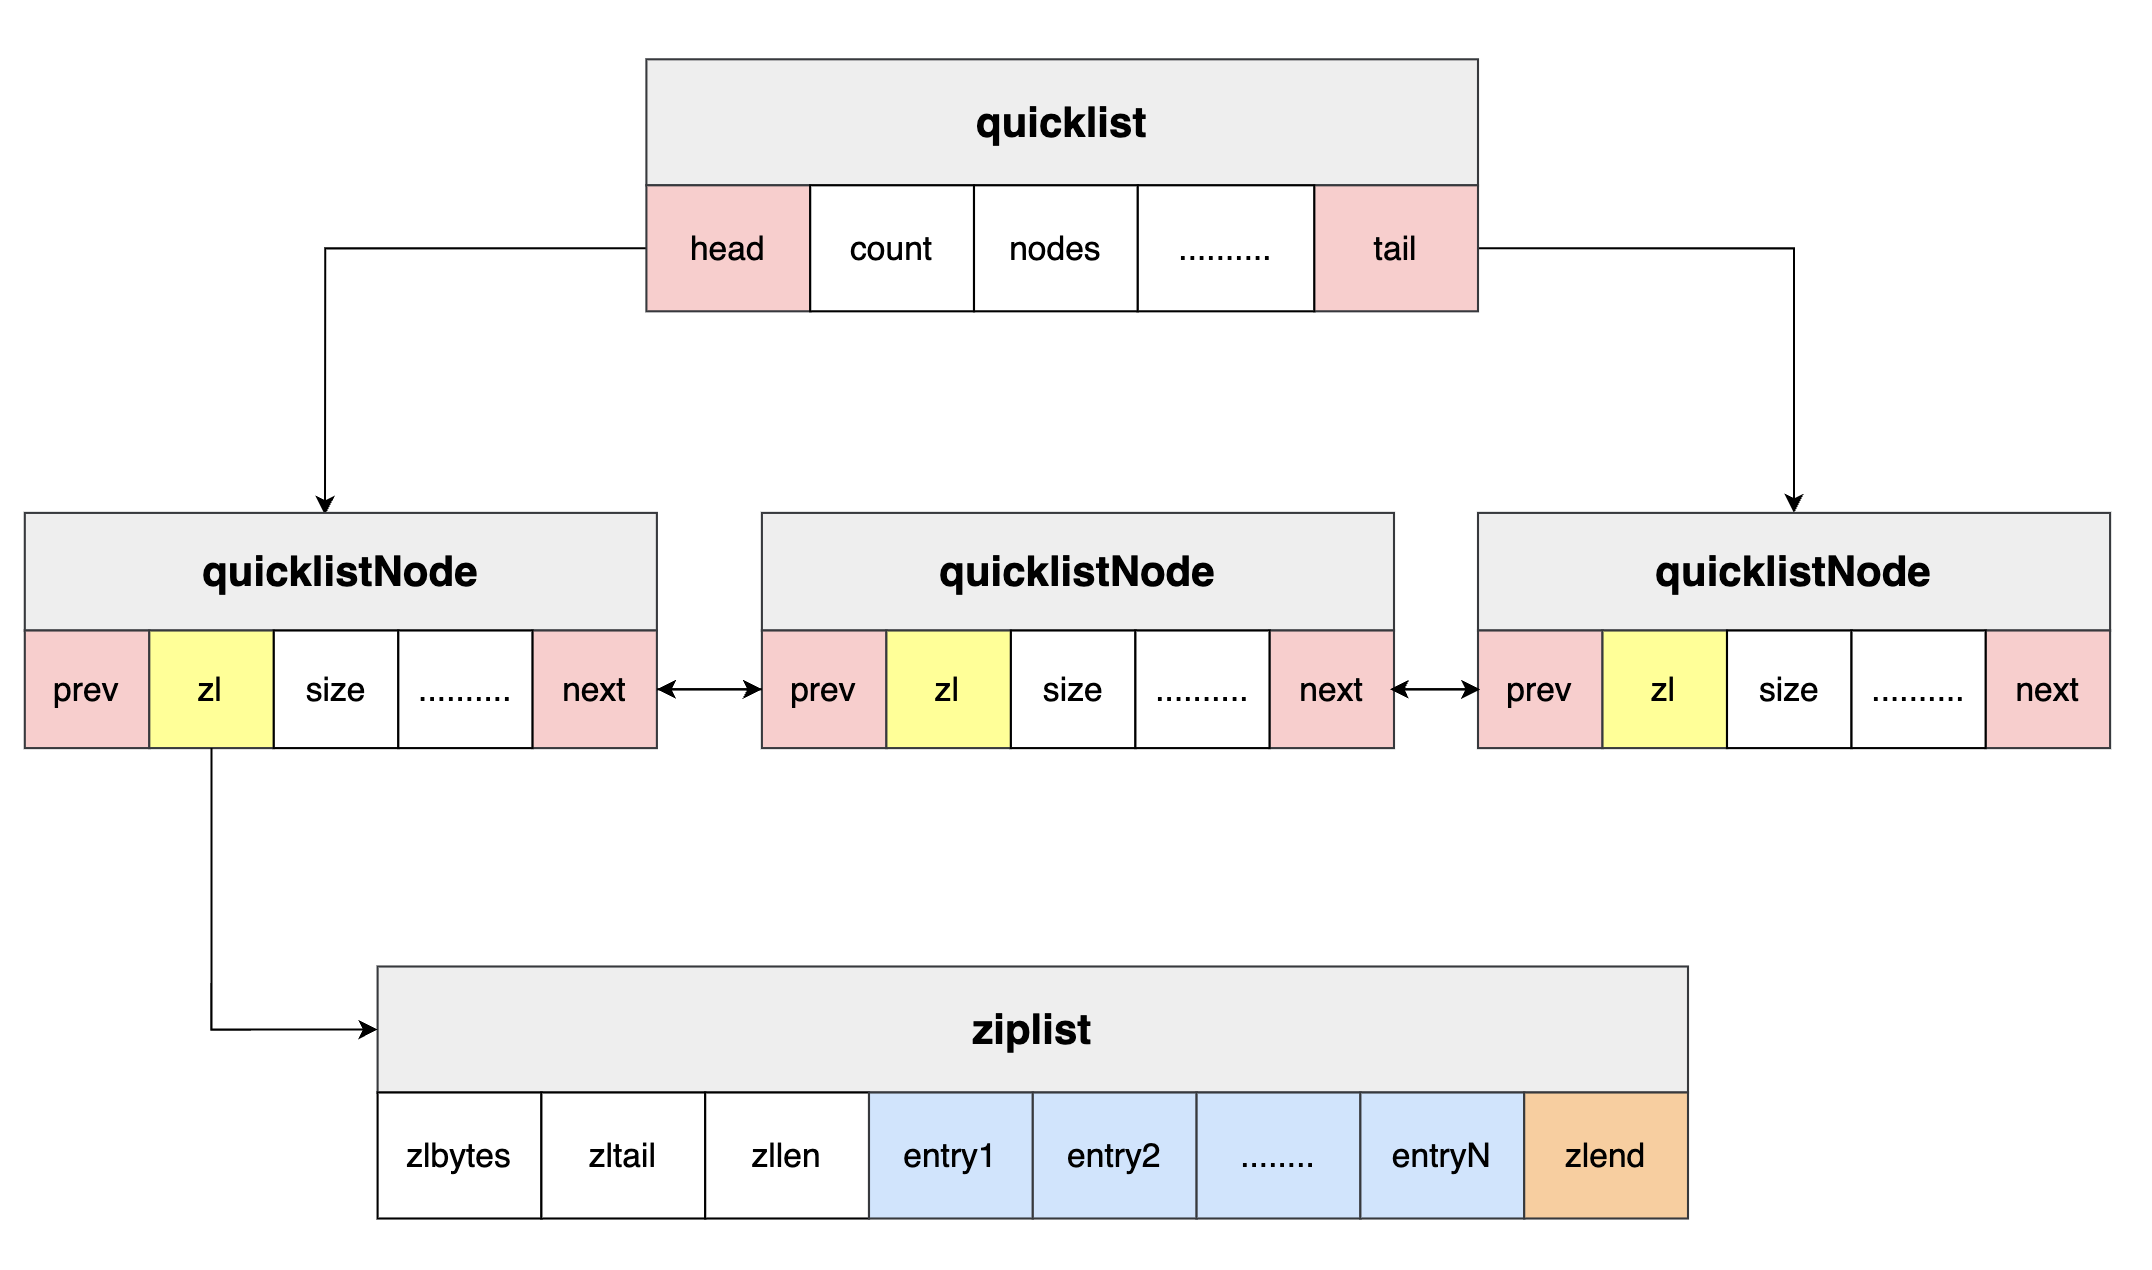
`quicklist` 说白了就是把 ziplist 和 list 双向链表结合起来,将大的 ziplist 拆分然后以链表的形式组织起来。
具体来说,每个链表节点中保存一个 ziplist,然后每个 ziplist 中存一部分数据,quicklist 内部默认单个 ziplist 长度为 8K 字节,超出了这个字节数,就会新起一个 ziplist。这样既可以避免大量链表指针带来的内存消耗,也可以避免 ziplist 过长导致连锁更新带来大量的性能损耗。
```c
// 快速列表
struct quicklist {
quicklistNode* head;
quicklistNode* tail;
long count; // 元素总数
int nodes; // ziplist 节点的个数
int compressDepth; // LZF 算法压缩深度
...
}
// 快速列表节点
struct quicklistNode {
quicklistNode* prev;
quicklistNode* next;
ziplist* zl; // 指向压缩列表
int32 size; // ziplist 的字节总数
int16 count; // ziplist 中的元素数量
int2 encoding; // 存储形式 2bit,原生字节数组还是 LZF 压缩存储
...
}
struct ziplist_compressed {
int32 size;
byte[] compressed_data;
}
struct ziplist {
...
}
```
示意图如下:
## listpack(Redis 5.0 引入)
ziplist 设计出的紧凑型数据块可以有效利用内存,但在更新上,由于每一个 entry 都保留了前一个 entry 的 prevlen 长度,因此在插入或者更新时可能会出现连锁更新,这是一个影响效率的大问题。
因此,接着又设计出 「链表 + ziplist」组成的 quicklist 结构来避免单个 ziplist 过大,可以有效降低连锁更新的影响面。
**但 quicklist 本质上不能完全避免连锁更新问题**,因此,又设计出与 ziplist 完全不同的内存紧凑型结构 listpack
```c
struct listpack<T>{
int32 total_bytes; // 总字节数
int16 size; // 元素个数
T[] entries; // 紧促排列的元素列表
int8 end; // 与 zlend 一样,恒为 0xFF
}
```
```c
struct lpentry{
int<var> encoding;
optional byte[] content;
int<var> length; // 当前 entry 的长度
}
```
示意图如下:
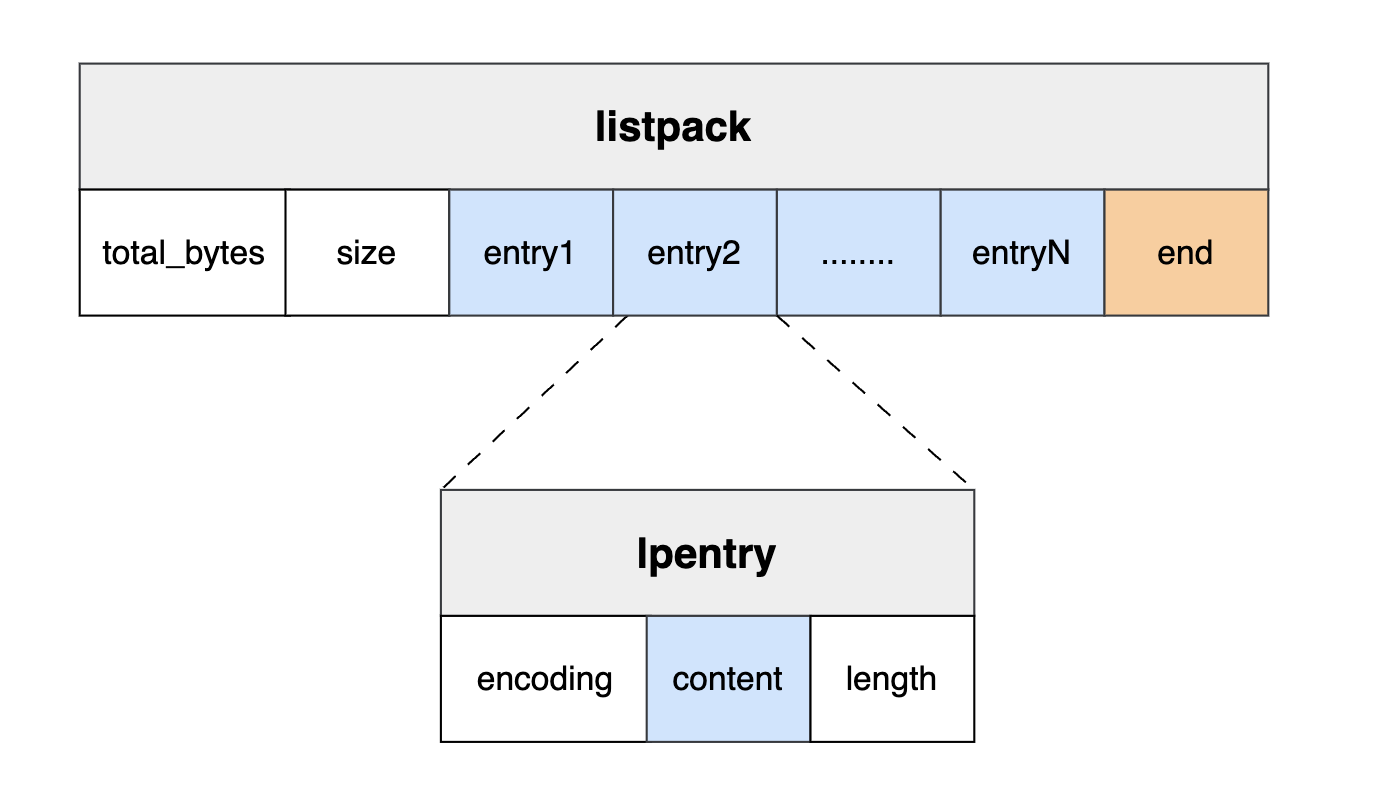
listpack 和 ziplist 结构很相似,只有两个不一样的地方:
- **少了一个 zltail_offset 字段**。这个字段是 ziplist 用来定位最后一个元素的位置,用于逆序遍历的,不过 listpack 可以根据 listpack 头中记录的 total_bytes 总长度直接定位到 listapck 的尾部结束标记,然后根据每个 entry 的长度逐个往前遍历
- **每个列表项都只记录自己的长度**,不会像 ziplist 的列表项会记录前一项的长度。所以在 listpack 中新增或修改元素,只会涉及到列表项自身的操作,不会影响后续列表项的长度变化,进而避免连锁更新
> ziplist 的不足主要在于一旦 ziplist 中元素个数多了,它的查找效率就会降低。而且如果在 ziplist 里新增或修改数据,ziplist 占用的内存空间还需要重新分配;更糟糕的是,ziplist 新增某个元素或修改某个元素时,可能会导致后续元素的 prevlen 占用空间都发生变化,从而引起连锁更新问题,导致每个元素的空间都要重新分配,这就会导致 ziplist 的访问性能下降。
>
> 所以,为了应对 ziplist 的问题,Redis 先是在 3.0 版本中设计实现了 quicklist。
>
> quicklist 结构在 ziplist 基础上,使用链表将 ziplist 串联起来,链表的每个元素就是一个 ziplist。这种设计减少了数据插入时内存空间的重新分配,以及内存数据的拷贝。同时,quicklist 限制了每个节点上 ziplist 的大小,一旦一个 ziplist 过大,就会采用新增 quicklist 节点的方法。
>
> 不过,又因为 quicklist 使用 quicklistNode 结构指向每个 ziplist,无疑增加了内存开销。为了减少内存开销,并进一步避免 ziplist 连锁更新问题,Redis 在 5.0 版本中,就设计实现了 listpack 结构。
>
> **listpack 结构沿用了 ziplist 紧凑型的内存布局,把每个元素都紧挨着放置。listpack 中每个列表项不再包含前一项的长度了,因此当某个列表项中的数据发生变化,导致列表项长度变化时,其他列表项的长度是不会受影响的,因而这就避免了 ziplist 面临的连锁更新问题**。
>
> 从 ziplist 到 quicklist,再到 listpack 结构;可以看到,Redis 的初衷都是设计一款数据结构能够高效的使用内存。