


字典 dict
@[toc]
---
Redis 所使用的 C 语言并没有内置字典结构,因此 Redis 构建了自己的字典实现(底层其实就是数组 + 链表)
## dict 的定义
**字典 dict**:
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20220609152550.png" style="zoom: 50%;" />
重点是 dictht ht[2] 和 rehashidx 属性,rehashidx 主要是用在 rehash 过程中
ht 属性是一个包含两个项的数组,数组中的每个项都是一个 dictht 哈希表(每个字典都使用两个哈希表)
一般情况下,字典只使用 ht[0] 哈希表,ht[1] 哈希表只会在对 ht[0] 哈希表进行 rehash 时使用
**哈希表 dictht**:
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20220609152626.png" style="zoom:50%;" />
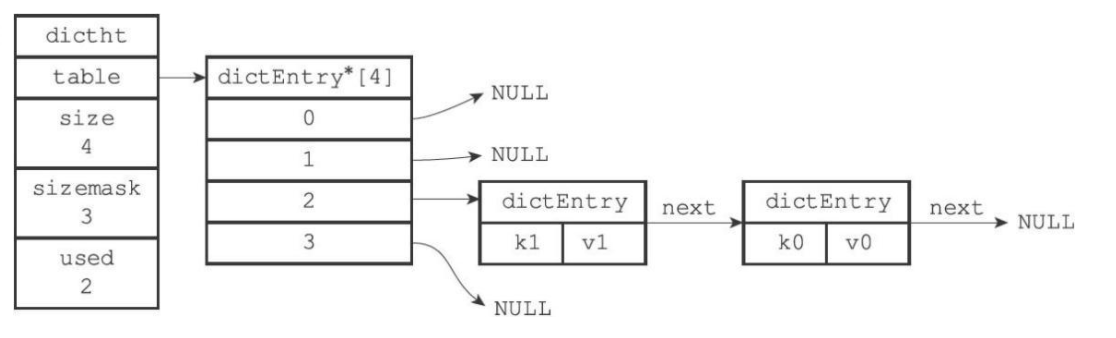
重点是 dictEntry 和 sizemask,sizemask 用来计算 key 的索引值,总是等于 size - 1
> key 对应的哈希表数组中索引值的计算方法:
>
> 1. 先计算 key 的哈希值:hash = dict.type.`hashFunction(key)`
> 2. 再根据哈希值计算索引值:index = `hash & dict.ht[x].sizemask`
**哈希表节点 dictEntry**
<img src="https://cs-wiki.oss-cn-shanghai.aliyuncs.com/img/20220609152806.png" style="zoom:50%;" />
每个 dictEntry 结构都保存着一个键值对
next 属性是指向另一个哈希表节点的指针,这个指针用来将多个哈希值相同的键值对连接在一次,以此来解决**键冲突**(collision)的问题 (**链地址法**)。
另外,因为 dictEntry 节点组成的链表没有指向链表表尾的指针,所以为了速度考虑,程序总是将新节点添加到链表的表头位置(头插法),复杂度为 O(1)
## 重新散列 rehash
### 什么是 rehash?
随着操作的不断执行,哈希表保存的键值对会逐渐地增多或者减少,为了让哈希表的**负载因子(load factor)**维持在一个合理的范围之内,当哈希表保存的键值对数量太多或者太少时,程序需要对哈希表的大小进行相应的扩展或者收缩,而这个过程又伴随着键值对的迁移。
**什么是负载因子?**
负载因子 = 哈希表已保存节点数量 / 哈希表大小
- 负载因子越大说明这个哈希表越拥挤
- 负载因子越小说明这个哈希表越稀疏
**rehash 的具体步骤**:
步骤 1:为字典的 ht[1] 哈希表分配空间。这个哈希表的空间大小取决于要执行的操作,以及 ht[0] 当前已有的键值对数量(也即是 `ht[0].used` 属性的值)
- 如果执行的是扩展操作,那么 ht[1] 的大小为第一个 >= `ht[0].used * 2` 的 $2^n$
> 举个例子,ht[0].used = 6,6 * 2 = 12,比 12 大的第一个 $2^n$ 的数是 16,所以如果执行的是扩展操作,那么 ht[1] 的大小就是 16
- 如果执行的是收缩操作,那么 ht[1] 的大小为第一个 >= `ht[0].used` 的 $2^n$
步骤 2:将 ht[0] 的键值对迁移(rehash)到 ht[1] 中,当然,由于数组大小发生变化,每个 key 对应的哈希值和索引值也相应地会发生变化
步骤 3:当 ht[0] 包含的所有键值对都迁移到了 ht[1]之后(ht[0] 变为空表),释放 ht[0],将 ht[1] 设置为 ht[0],并新创建一个空白哈希表作为新的 ht[1],为下一次 rehash 做准备
### 渐进式 rehash
**什么是渐进式 rehash?**
扩展或收缩哈希表需要将 ht[0] 里面的所有键值对 rehash 到 ht[1] 里面,但是,这个 rehash 动作并不是一次性、集中式地完成的,而是分多次、渐进式地完成的
**为什么需要渐进式?**
如果 ht[0] 里只保存着少数几个键值对,那么服务器可以在瞬间就将这些键值对全部 rehash 到 ht[1]
但是,如果哈希表里保存的键值对数量不是四个,而是四百万、四千万甚至四亿个键值对,那么要一次性将这些键值对全部 rehash 到 ht[1] 的话,<u>庞大的计算量可能会导致服务器在一段时间内停止服务</u>
**渐进式 rehash 的具体步骤**:
步骤 1:为 ht[1] 分配空间,让字典同时持有 ht[0] 和 ht[1] 两个哈希表(这一步和 rehash 一样)
步骤 2:在字典中维持一个索引计数器变量 `rehashidx`(dict 里面的属性,上面我提到过让大家额外注意),初始化为 0,表示 rehash 工作正式开始
步骤 3:在 rehash 进行期间,每次对字典执行添加、删除、查找或者更新操作时,程序除了执行指定的操作以外,还会顺带将 ht[0] 哈希表在 rehashidx 索引上的所有键值对 rehash 到 ht[1],当 rehash 工作完成之后,程序将 rehashidx 属性的值增一
> 简单来说,就是<u>将所有键值对的 rehash 工作均摊到对字典的每个添加、删除、查找和更新操作上,从而避免了集中式 rehash 而带来的庞大计算量</u>
在渐进式 rehash 进行期间,字典的删除、查找、更新等操作会在两个哈希表上进行
- 例如,<u>要在字典里面查找一个键的话,程序会先在 ht[0] 里面进行查找,如果没找到的话,就会继续到 ht[1] 里面进行查找</u>
- 另外,<u>在渐进式 rehash 执行期间,新添加到字典的键值对一律会被保存到 ht[1] 里面</u>,而 ht[0] 则不再进行任何添加操作,这一措施保证了 ht[0] 包含的键值对数量会只减不增,并随着 rehash 操作的执行而最终变成空表
步骤 4:最终在某个时间点上,ht[0] 的所有键值对都会被 rehash 至 ht[1],这时程序<u>将 rehashidx 属性的值设为 -1,表示 rehash 操作已完成</u>